
NVIDIA一声不响开放了底层GPU调度权?
近日,NVIDIA App推送11.0.9.585版本更新。部分用户发现,系统设置的高级菜单中出现了一个名为“GPU App Prioritization”的新选项。该功能允许用户手动调整前台应用与后台任务的GPU资源调度优先级,并提供四档预设:默认模式下前台与后台分配比例为80比20;开启前台优先后调整为90比10;自定义模式可将前台优先级拉高至95,后台压缩至5。
有RTX 5090用户报告成功激活该选项,但在相同软件版本下的RTX 5070 Ti和RTX 4090系统中暂未显示。可见该功能目前处于分批推送阶段,使用范围相对有限。
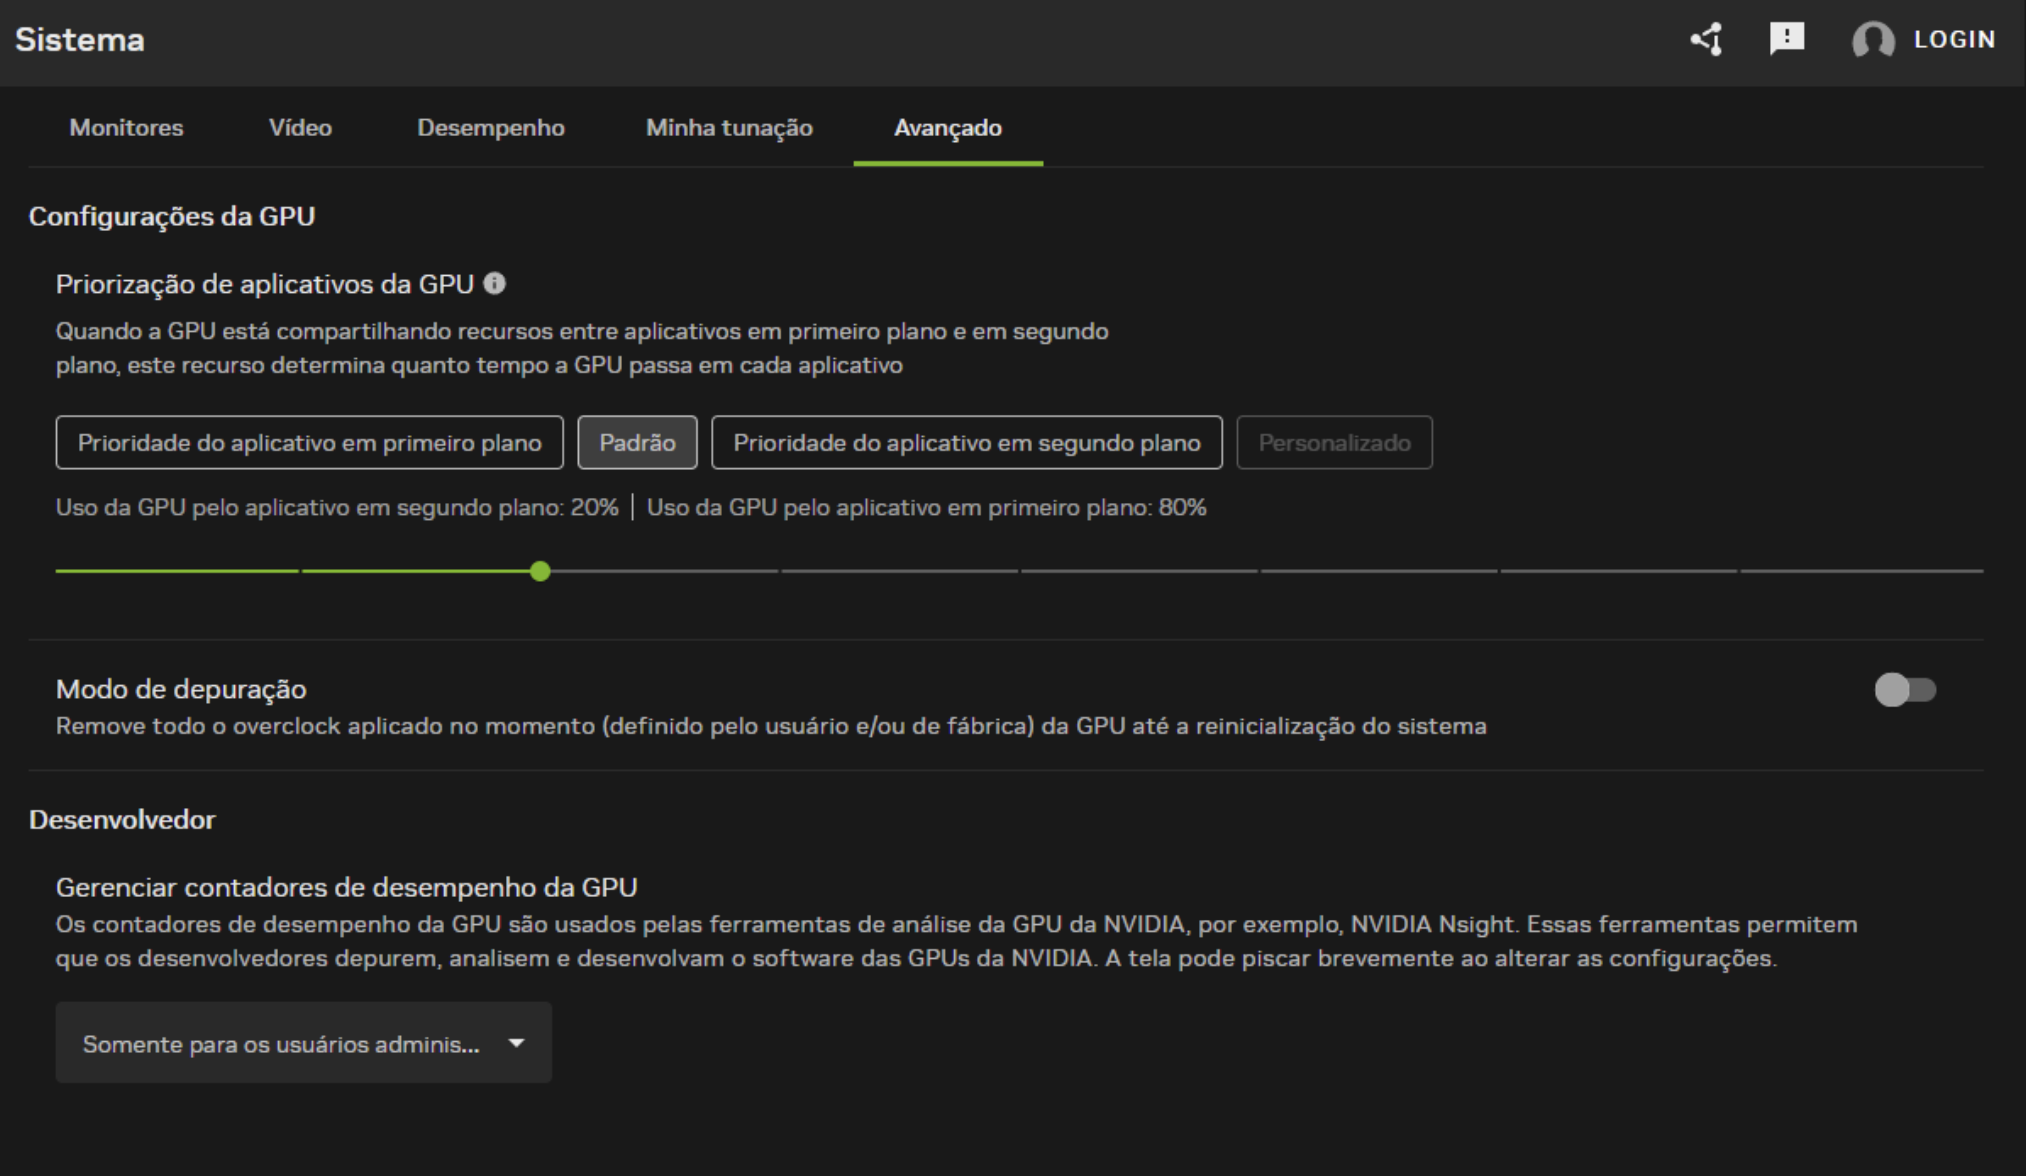
来源:GameGPU
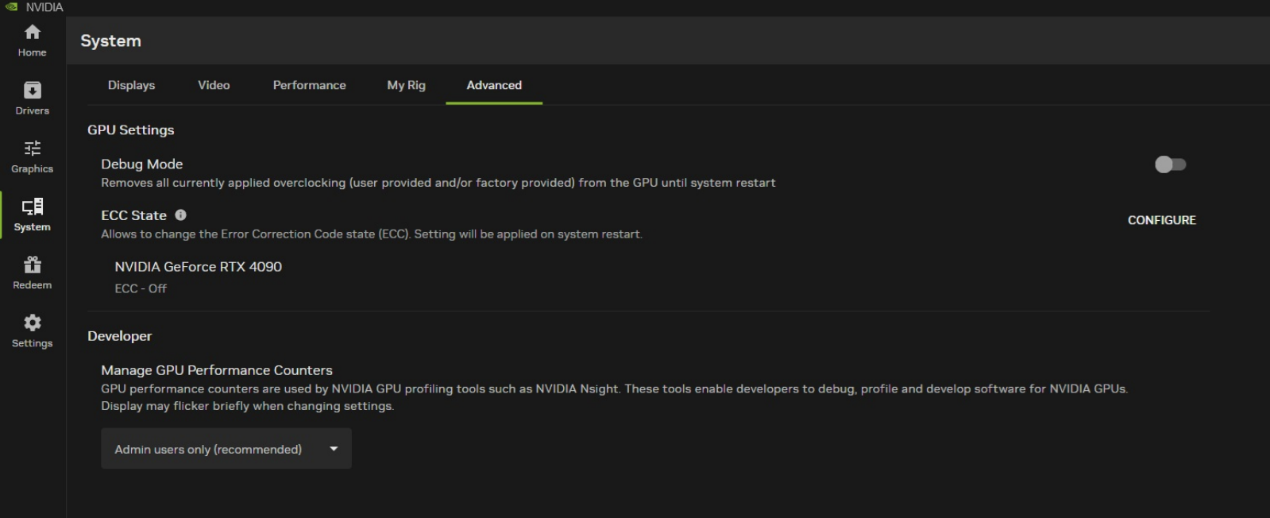
来源:wccftech
英伟达此前曾于10月28日公布面向RTX Spark设备的GPU资源优先级管理能力,要求启用Windows硬件加速GPU计划。此次在GeForce消费级显卡上出现的功能选项,表明该底层调度技术正在向更广泛的硬件平台进行部署。
多任务并发常态化,GPU资源调度细化
过去,显卡的主要任务是图形渲染,前台游戏独占绝大多数GPU资源。但随着本地AI推理的普及,在个人工作站和开发者的真实使用中,一边在前台运行图形渲染或专业软件,一边在后台跑本地大模型推理或视频导出,已成为常见的高频并发模式。
这类组合对GPU的争夺并非简单的先到先得,而是前台任务对响应延迟极度敏感,后台任务对数据吞吐有刚性需求。当两者在同一块硅片上产生资源冲突时,会导致系统整体体验显著劣化。
NVIDIA App此前作为驱动设置和游戏优化的统一入口,并未提供面向混合负载的GPU资源分配机制。GPU App Prioritization的出现,本质上是将过去由驱动在后台自动分配、用户无法干预的调度过程,部分转化为可配置项。默认的80比20和上限的95比5提供的是一个调节刻度,而非硬性算力切分。从产品演进方向来看,GPU的任务管理正在从单任务独占模式,向多任务优先级分配机制迁移。
软件级优先级调度,填补消费级硬件隔离的空白
GPU内部的计算单元、显存带宽、编解码器引擎在物理上是共享的。当多个应用同时提交工作负载时,调度器需要在不同队列之间分配时间片和执行资源。传统的优先级机制主要在驱动层面自动运行,用户只能通过操作系统或第三方工具做粗粒度干预。NVIDIA App将调节入口上移,意味着英伟达正在尝试通过软件层面对硬件调度策略进行更精细的控制。
这一路径与数据中心GPU上早已存在的MIG(多实例GPU)和SR-IOV等硬件级隔离技术形成对照。MIG将一颗物理GPU切分为多个独立实例,每个实例拥有专属的计算单元和显存分区,属于物理层面的硬隔离。消费级显卡不具备MIG那样的硬件切分能力,NVIDIA App提供的是调度优先级层面的软件控制。
它虽然不保证前台应用获得固定比例的物理算力,但可以在资源竞争时改变不同任务被服务的先后次序。这种软件级调度的实际效果,短期内难以用帧率提升来量化。其核心价值在于降低了多任务并发时系统响应的不确定性。对于需要一边跑本地推理一边保持交互流畅的用户,一个可调节的调度优先级,比一个理论上更高但被后台任务频繁打断的峰值性能更有工程意义。
当GPU从单一的图形渲染设备演变为集图形、AI推理、视频处理于一体的异构计算平台,上层软件对底层资源分配的可控性,正在成为衡量产品体验的重要指标。
分批开放传递产品信号,多任务GPU管理加速演进
NVIDIA这种针对特定硬件优先开放的方式,传递了一个明确的产品信号:NVIDIA正在验证用户对GPU资源管理的真实需求强度。
如果这一功能最终稳定下放,其意义将超越NVIDIA App本身。它标志着桌面GPU的定位正在发生扩展,从一个只是执行图形API的硬件,成为一个需要被操作系统和上层软件以多任务算力资源的方式来管理的计算设备。用户对GPU的认知,也在从单纯的图形渲染工具向并发负载管理平台迁移。
这个迁移的完成度,不取决于某一个调度滑块的存在与否,而取决于驱动、操作系统和上层应用能否围绕多任务资源分配形成一套稳定的协同规则。NVIDIA在11.0.9.585版本中增加的这一选项,正是这一协同规则形成的初步尝试。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序