
放弃4F²,美光明确下一代存储路线
上个月,美光对外披露了未来数年的DRAM与NAND闪存技术路线图,公布将采用晶圆键合、能够缩小NAND存储单元的新材料、高NA EUV光刻技术,同时详解3D DRAM的研发布局。这份路线图里最值得关注的一点是:随着AI开发人员越来越需要适配自家处理器架构、特定负载的存储方案,美光计划扩充定制化DRAM与NAND产品矩阵。
美光总裁兼首席技术与产品官Scott DeBoer在本月早些时候的公司活动上表示:“目前DRAM已经逼近物理原子极限。虽然我们还有好几代平面工艺节点可以迭代,但我们重点考量,要在成本、性能综合最优的时机推出3D DRAM。对于3D NAND,我们的核心方向是依靠新材料压缩存储单元结构密度,持续推进XYZ三维缩放。”
DRAM:放弃4F² 单元、高NA EUV、新材料、3D DRAM开启下一代微缩
一个出人意料的调整是,美光决定放弃研发4F² 存储单元DRAM方案,这和长鑫存储、三星、SK海力士的路线不同。美光给出的理由是,在现有工艺基础上,4F² 单元没有可行的持续微缩路径。 取而代之,美光未来路线图包含晶圆键合、高NA EUV光刻、新材料,最终落地3D DRAM。公司计划2027年下半年启动下一代1δ 存储工艺的量产;后续的1ε、ζÅ、ηÅ工艺均处于不同研发阶段。与此同时,美光同步开发两代3D DRAM,未来有望替代传统平面存储。
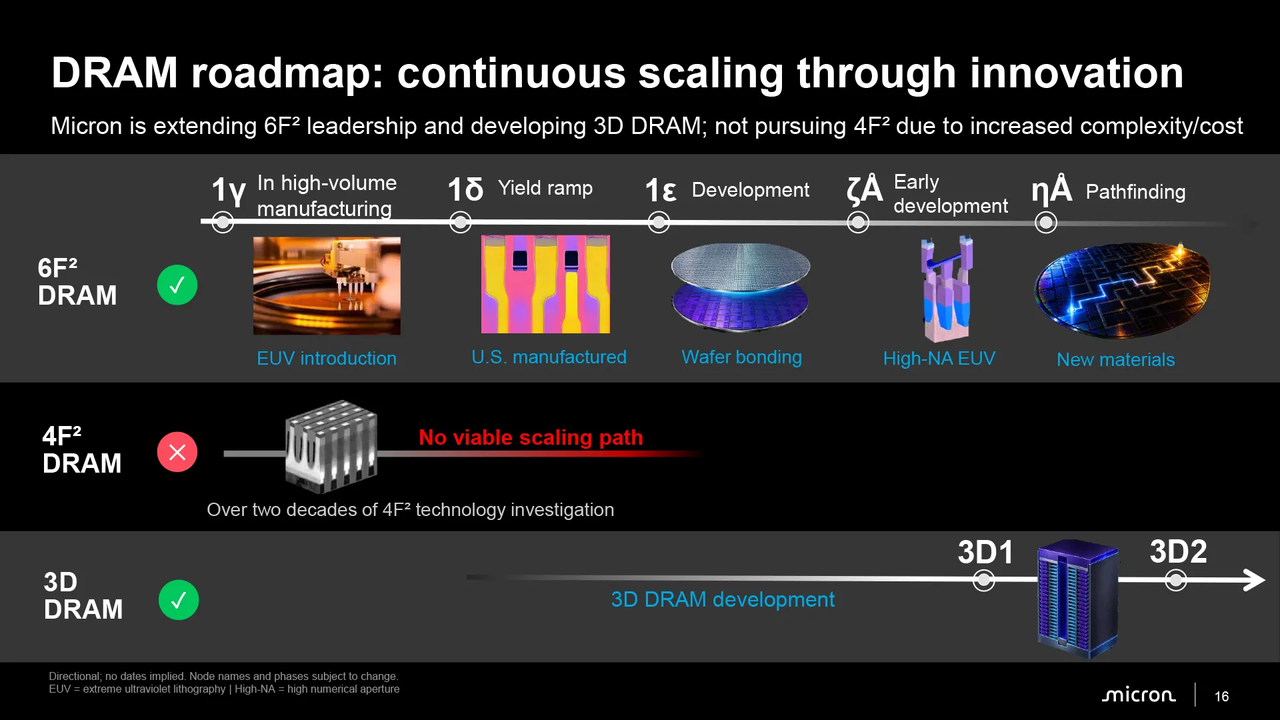
美光当前已经大规模量产的1γDRAM工艺,是它首款采用EUV光刻的DRAM节点。此前美光一直依靠DUV多重曝光工艺,依然和采用EUV加工关键层的三星、SK海力士保持竞争。
下一代1δ 工艺目前处于良率爬坡阶段,预计2027年下半年量产。美光称,该工艺比特密度相比1γ 提升约20%;先进高k金属栅(HKMG)CMOS、新材料、埃级工艺控制以及设备智能化,将改善性能、功耗,同时优化良率与成本。
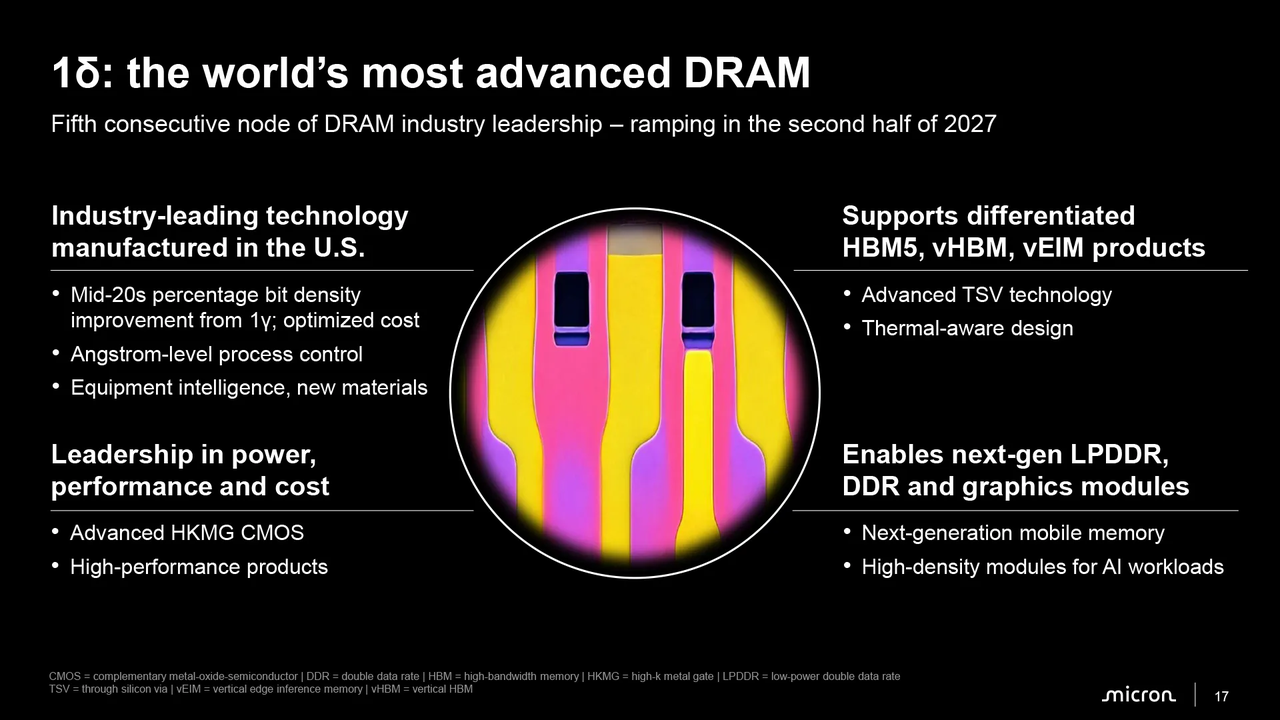
美光将在美国本土生产1δDRAM,该工艺用于新一代DDR、LPDDR、图形内存、HBM5、垂直HBM(vHBM)以及垂直边缘推理内存(vEIM)。为生产HBM5、vHBM5、vEIM产品,该节点还支持硅通孔(TSV)等配套技术,优化散热性能。
再往后的1ε 工艺将引入晶圆键合技术:可以在不同晶圆上制备不同结构,再把两片晶圆键合在一起。该方案能提升存储设计与制造的灵活性,但美光尚未公布键合方案、键合结构,以及密度、性能、功耗的提升幅度。该工艺还在研发,暂无量产时间表。
ζÅ节点尚处于早期开发阶段,会把高NA EUV光刻引入存储制造,进一步缩小关键尺寸。美光没有披露需要使用高NA光刻的层数、预期密度增幅以及量产时间。但可以确定,该节点至少要到2030年才会落地,晚于三星、SK海力士计划2028年在DRAM产线部署高NA EUV的节奏。
ηÅ是美光披露的平面DRAM路线图里最晚的一代,目前处于路线探索阶段。在DRAM产线引入高NA EUV之后,美光将依靠其他微缩手段继续迭代。虽然提到了新材料,但暂未公布具体材料种类,也没有说明对器件结构的影响。候选材料包括新型光刻胶、沉积前驱体、介电材料、导电材料,用来制造更小的晶体管与电容,最终提升DRAM单元密度。
总而言之,美光路线图坚持基于6F² 单元迭代DRAM,和长鑫、三星、SK海力士的路线存在差异。
3D1、3D2:3D DRAM时代临近
在传统平面DRAM之外,美光同步研发两代3D DRAM,代号3D1、3D2。平面DRAM主要依靠缩小存储单元来提升比特密度;而3D DRAM利用垂直方向,在同样面积内容纳更多存储单元。美光计划等到3D DRAM在制造成本、性能上可以对标传统DRAM时,再推向市场。目前没有公布架构、堆叠层数和密度目标。
事实上,美光规划了到2030年的存储架构,但DRAM路线图里只有1δ 工艺给出明确量产窗口(2027下半年大规模量产),后续平面DRAM节点以及两代3D DRAM均未公布投产时间。
定制HBM与垂直内存架构
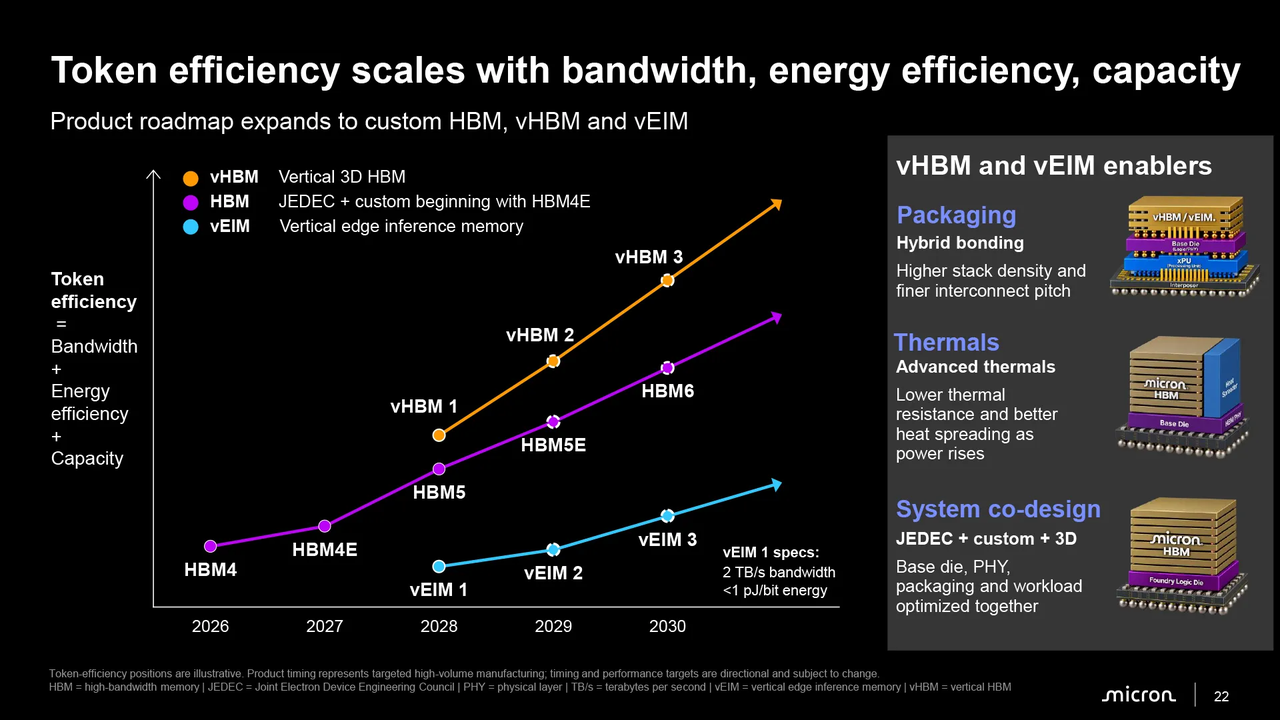
除常规DRAM之外,美光打算在新一代工艺上开发HBM4E、HBM5、HBM5E以及全新垂直集成内存架构。从HBM4E开始,美光将同时提供标准版与定制版HBM,后续还有定制HBM5E、vHBM、vEIM(垂直边缘推理内存)。这标志着定制化存储重回大规模量产产品线。
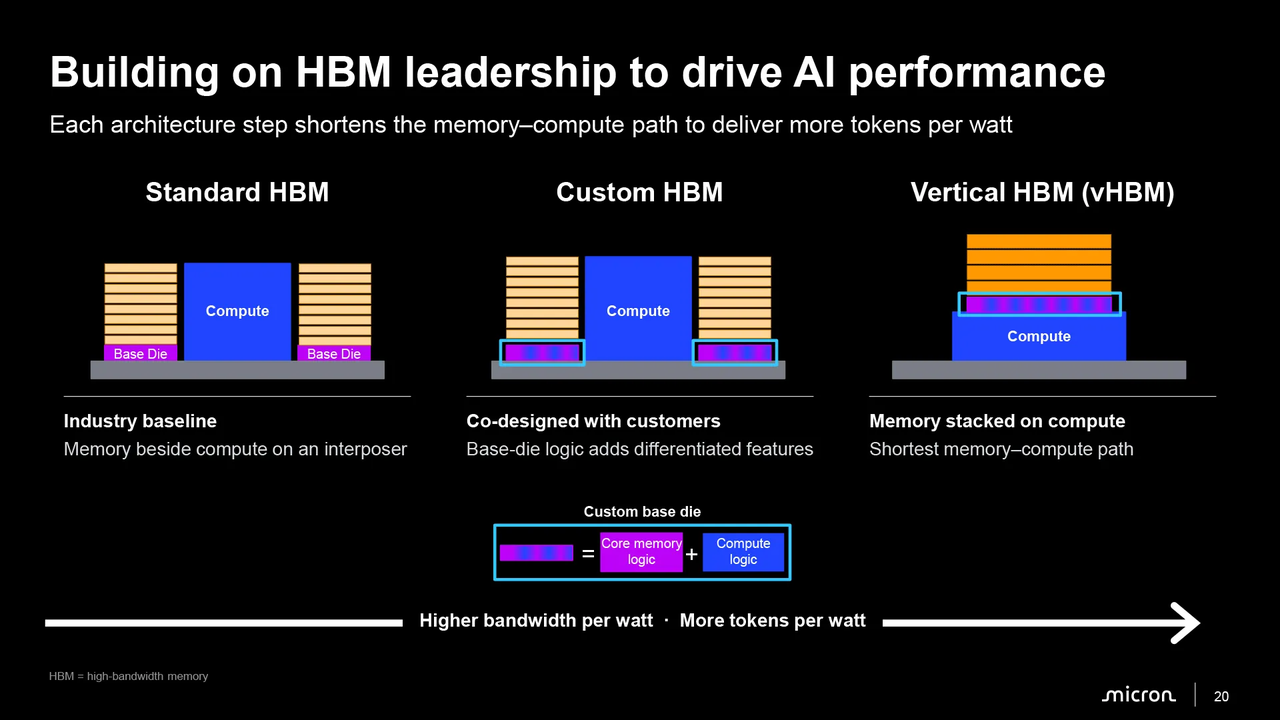
定制HBM4E(cHBM4E)支持客户缩减内存I/O位宽,或是在HBM基底晶圆上集成额外逻辑电路,释放宝贵的芯片面积给算力单元,针对特定AI加速器优化性能与功耗。Scott DeBoer表示,这些逻辑原本放在ASIC内部,把它们放到靠近存储的基底晶圆上,能够提升整套系统效率。
DeBoer说:“我们和客户协同设计基底晶圆,放到基底晶圆上的逻辑电路,本质上是从GPU电路里剥离出来的功能,挪到离存储更近的位置。等到垂直HBM阶段,把适合的电路迁移到基底晶圆上依然是可行方案。”
为支撑这类功能,美光计划在标准和定制HBM的基底晶圆上采用先进代工工艺,具体节点暂未披露。定制方案会挑选满足客户需求、性价比最优的工艺。例如HBM4E就需要更先进的CMOS工艺,达成性能与功耗目标。
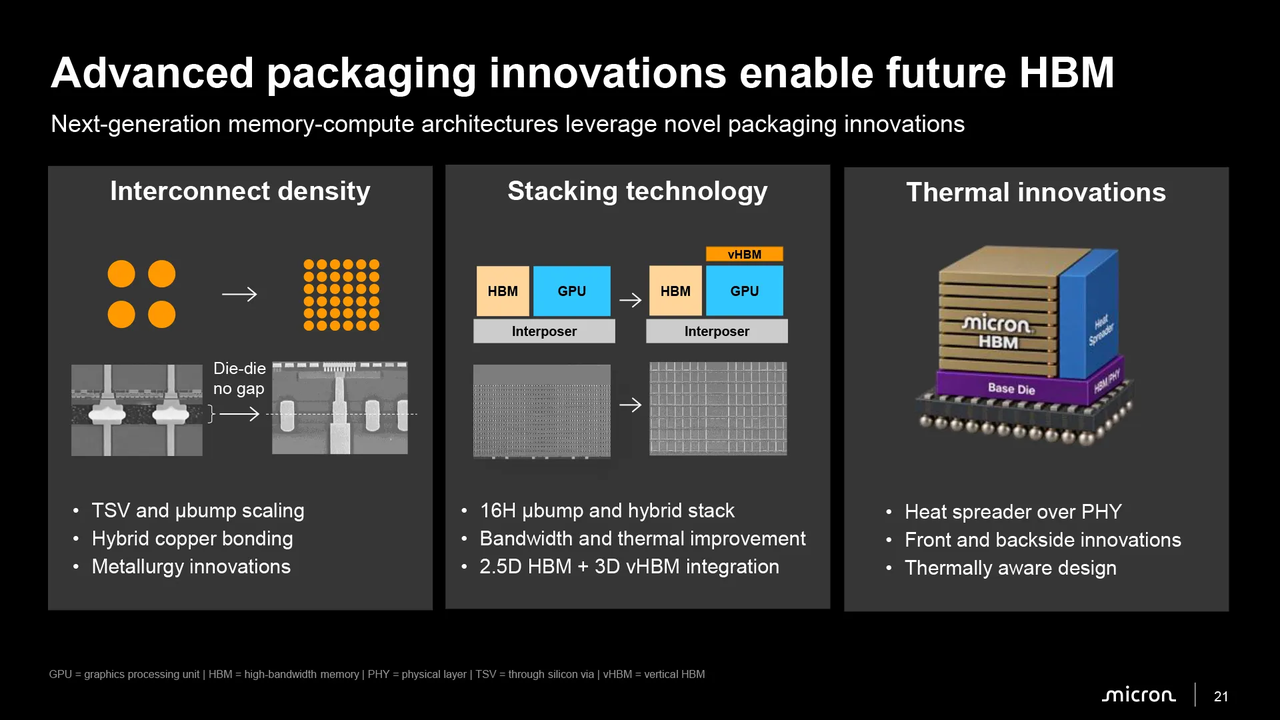
后续美光将推出垂直HBM(vHBM):内存直接堆叠在ASIC、CPU上方,而不是像传统方案那样放在中介层旁边。依靠密集垂直互联,vHBM带宽会大幅提升;就近集成也能降低延迟,但供电、散热的挑战也显著增加。美光计划采用混合键合实现先进互联、集成散热片、热感知设计来应对难题。有意思的是,美光认为传统HBM和vHBM会长期共存:vHBM提供极限带宽,普通HBM负责大容量需求。
另一款在研产品是垂直边缘推理内存vEIM,它和HBM共享大部分封装、集成技术,但优先面向功耗敏感场景,而非极致带宽。第一代vEIM目标实现接近HBM4的2TB/s带宽,同时单比特传输能耗低于1皮焦。
这两种架构都需要深度协同客户,针对特定应用优化存储、逻辑、封装与散热方案,vHBM、vEIM的落地离不开客户合作。美光的定制化开发不止局限于HBM和EIM。
举例来说,美光正在和Meta协同优化面向数据中心的LPDDR6,重点围绕可靠性、可维护性、可用性。美光预计LPDDR6相比LPDDR5功耗下降约35%,对于高密度存储部署意义重大。美光还将和头部客户联合开发DDR6,目标带宽是DDR5的两倍,更好匹配需求。
谈及客户协同,DeBoer强调,美光现在从产品定义早期就和客户联合设计、联合开发、联合验证、规模交付,和过去的合作模式有很大区别。
“在AI协同创新项目里,我们和客户一起构想、联合设计、协同开发、联合验证,最后规模化交付。这种机会非常独特,和三四年前我们和客户的合作方式完全不一样。”
先进CMOS:性能提升超10倍
除DRAM单元微缩、垂直内存架构之外,美光还在研发用于外围电路的先进CMOS工艺。路线图包含多代高k金属栅结构的DRAM CMOS逻辑,之后还有第一代、第二代3D CMOS。
美光预计,2020至2030年间,这套CMOS逻辑性能提升幅度超过10倍,用来满足AI存储产品持续上涨的带宽与功耗需求。
3D NAND:从400层新一代3D NAND到AI专用NAND
本次发布会重心虽然是DRAM,但美光也公布了NAND闪存的新进展,包含第11代400层3D NAND、G11之后的下一代3D NAND,以及主打高带宽或高IOPS的AI专用NAND。
美光G11(N170)3D NAND工艺,相比当前G9(N160)有巨大革新。有源存储层数从276层提升至400层以上,引入晶圆对晶圆键合,采用行业领先的存储单元节距。
升级之后,G11 3D NAND的比特密度相比G9翻倍,以3D TLC为例,密度有望从21Gb/mm² 提升至42Gb/mm²;良率成熟之后,单比特制造成本会明显下降。
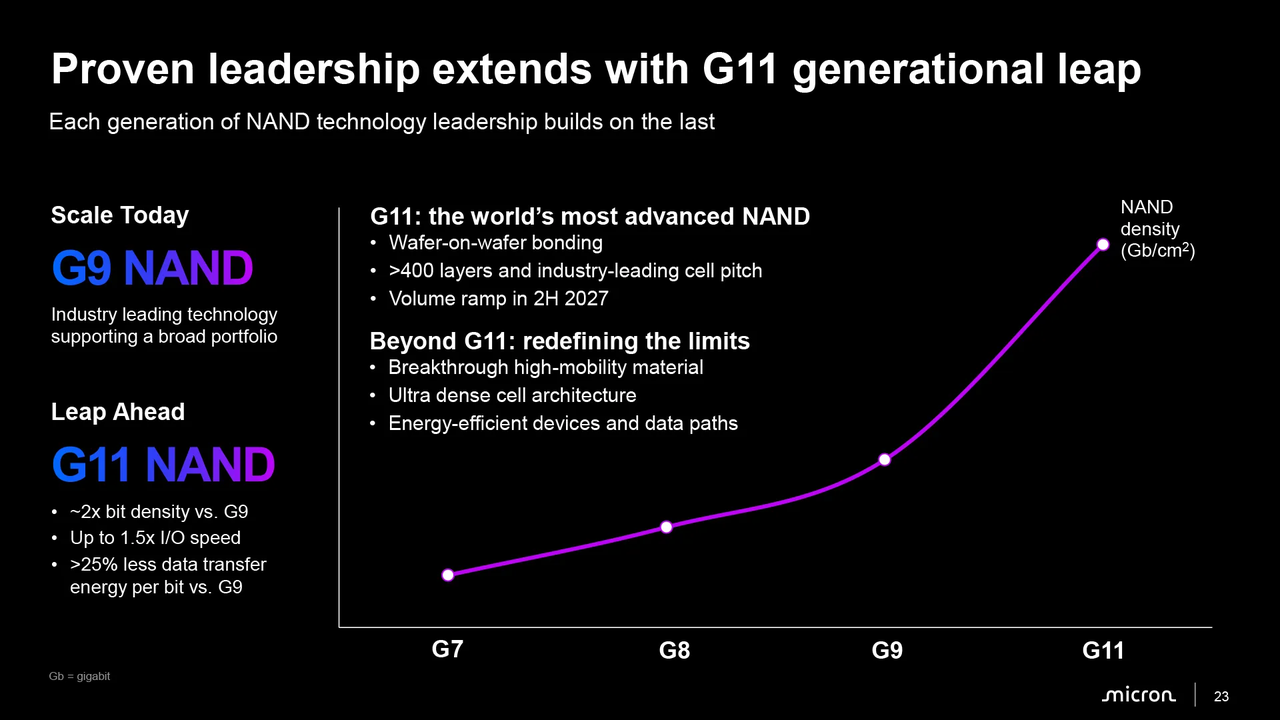
除存储密度提升之外,G11的I/O速度相比G9提升50%,速率约5400MT/s。同时单比特传输能耗降低25% 以上,对于大容量SSD、海量数据搬运的AI存储系统十分关键。
G11最重要的变化之一就是引入晶圆对晶圆键合:存储阵列和外围、I/O电路分别在两片晶圆制备,之后键合在一起。长江存储早已采用该技术提升容量与性能,所以美光以及其他存储厂商跟进该方案并不意外。
美光计划2027年下半年启动G11 3D NAND量产。
G11之后的3D NAND迭代:新材料与XYZ三维缩放
G11之后,美光会依靠新材料、更紧凑的单元结构、更低功耗的电路与数据通路持续迭代3D NAND。具体方向包括高迁移率材料,改善存储器件电学特性;以及超高密度单元架构,在堆叠层数之外继续拉高存储密度。
低功耗电路与数据通路,用来抵消NAND容量提升、接口提速带来的功耗上涨。
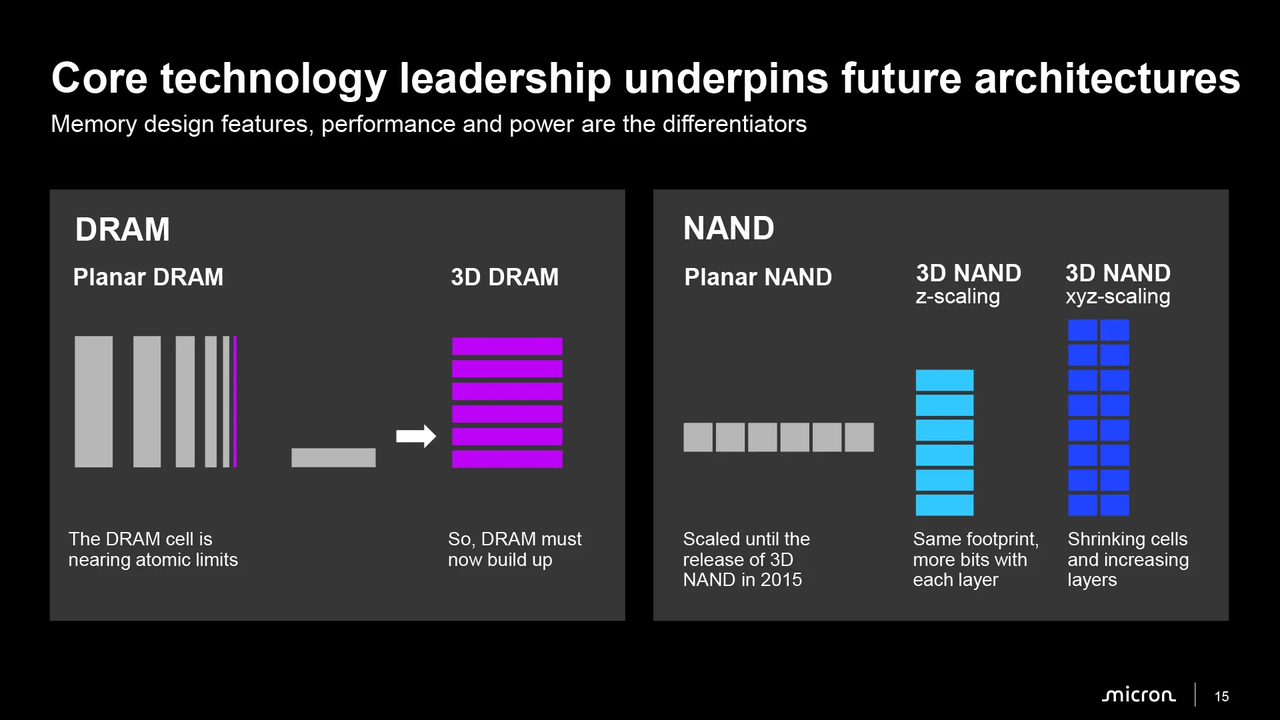
DeBoer表示:“G11之后我们有清晰路线,今天不展开细说。核心方向就是依靠新材料压缩单元密度,持续推进XYZ三维缩放。当前行业和美光的思路是两条腿走路:一方面增加堆叠层数,另一方面缩小存储单元尺寸。”
美光暂未公布新材料种类,也没有给出G11之后各代NAND的密度、性能、功耗量化指标。
AI专用NAND:高IOPS与高带宽两条路线
虽然G12、G13 3D NAND细节暂未公开,但美光披露正在开发两款面向AI的专用NAND架构。
第一款是高随机IOPS AI NAND,主打极致随机读写性能,基于SLC、小块设计,加速向量检索、图分析、AI上下文管理等负载。美光预计产品IOPS区间在2500万~1亿,取决于配置,相关产品将在未来两年陆续推出。
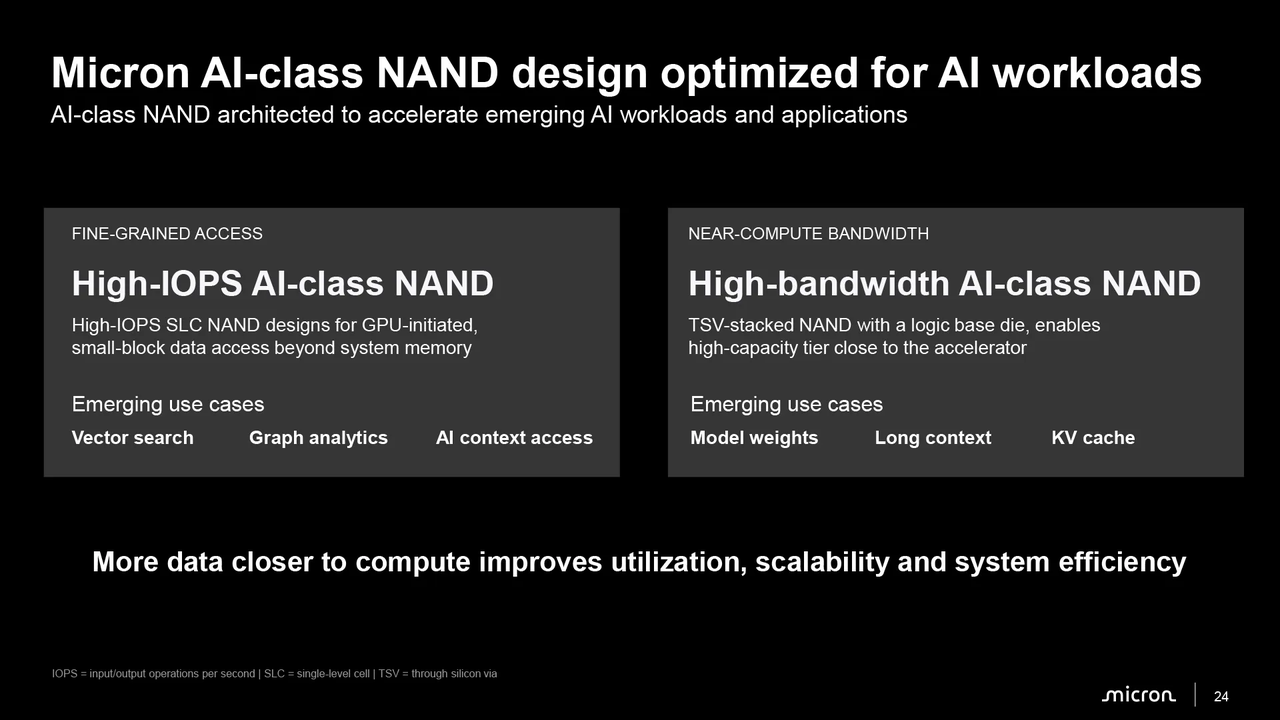
第二款是高带宽AI NAND,优先保障带宽而非随机性能。美光探索采用TSV堆叠NAND,搭配逻辑基底晶圆,贴近AI加速器。这个概念和闪迪HBF有相似之处。但美光认为,仅仅把NAND堆叠放在中介层上、挨着GPU,价值有限。美光正在探索别的集成方案,让NAND更靠近算力核心,同时不占用加速器宝贵的边缘走线区域。
DeBoer说:“高带宽AI NAND成本更高,必须和客户联合落地,保证成本和价值匹配。我们开发TSV堆叠NAND + 逻辑基底晶圆,拉近存储和加速器的距离。我们不认为放在GPU边缘走线区是好方案,要让存储更贴近算力,发挥这套高性能NAND的价值。”
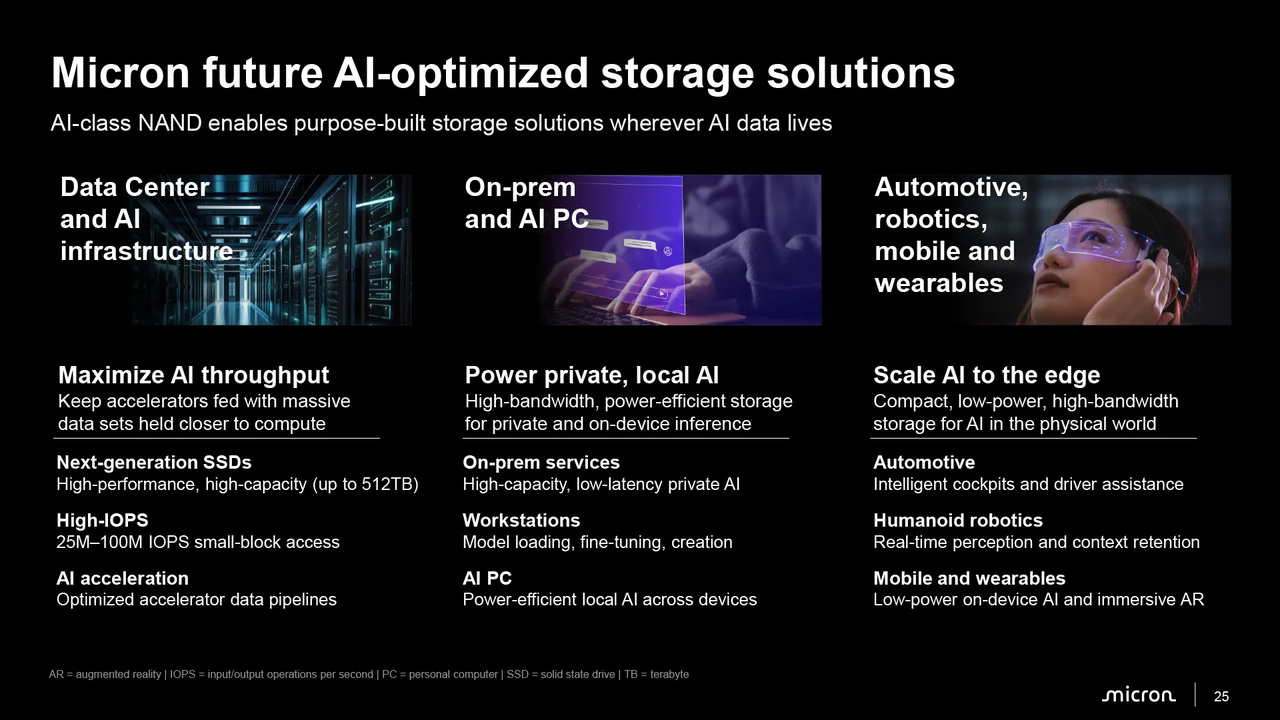
这类AI专用NAND,会和美光常规SSD路线互为补充,常规路线包含未来最高512TB容量的固态硬盘。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序