
Day-0支持,摩尔线程率先完成阶跃星辰Step 5 Preview大模型适配
10月15日,阶跃星辰开源新一代旗舰大模型Step 5 Preview。同日,摩尔线程旗舰级AI训推一体智算卡MTT S5000及MUSA软件栈完成对该模型的Day-0极速适配与高效运行,充分体现了摩尔线程紧跟前沿大模型迭代的敏捷适配能力,也再次印证了国产全功能GPU能够为超长上下文的Agentic模型提供可靠的算力底座。
Step 5 Preview 是一款面向真实世界 Agentic 任务的旗舰基座模型。Step 5 Preview 在 AI 编程、软件工程、专业知识工作等任务上达到前沿水平,并在金融领域展现出尤为突出的能力。Step 5 Preview 采用稀疏 MoE 架构,总参数量 600B,每个 Token 激活 27B 参数,支持 1M Token 上下文窗口和视觉输入。从公开评测到内部测试,Step 5 Preview 在软件工程、Agent、专业工作和金融等多个方向上都取得了有竞争力的结果。
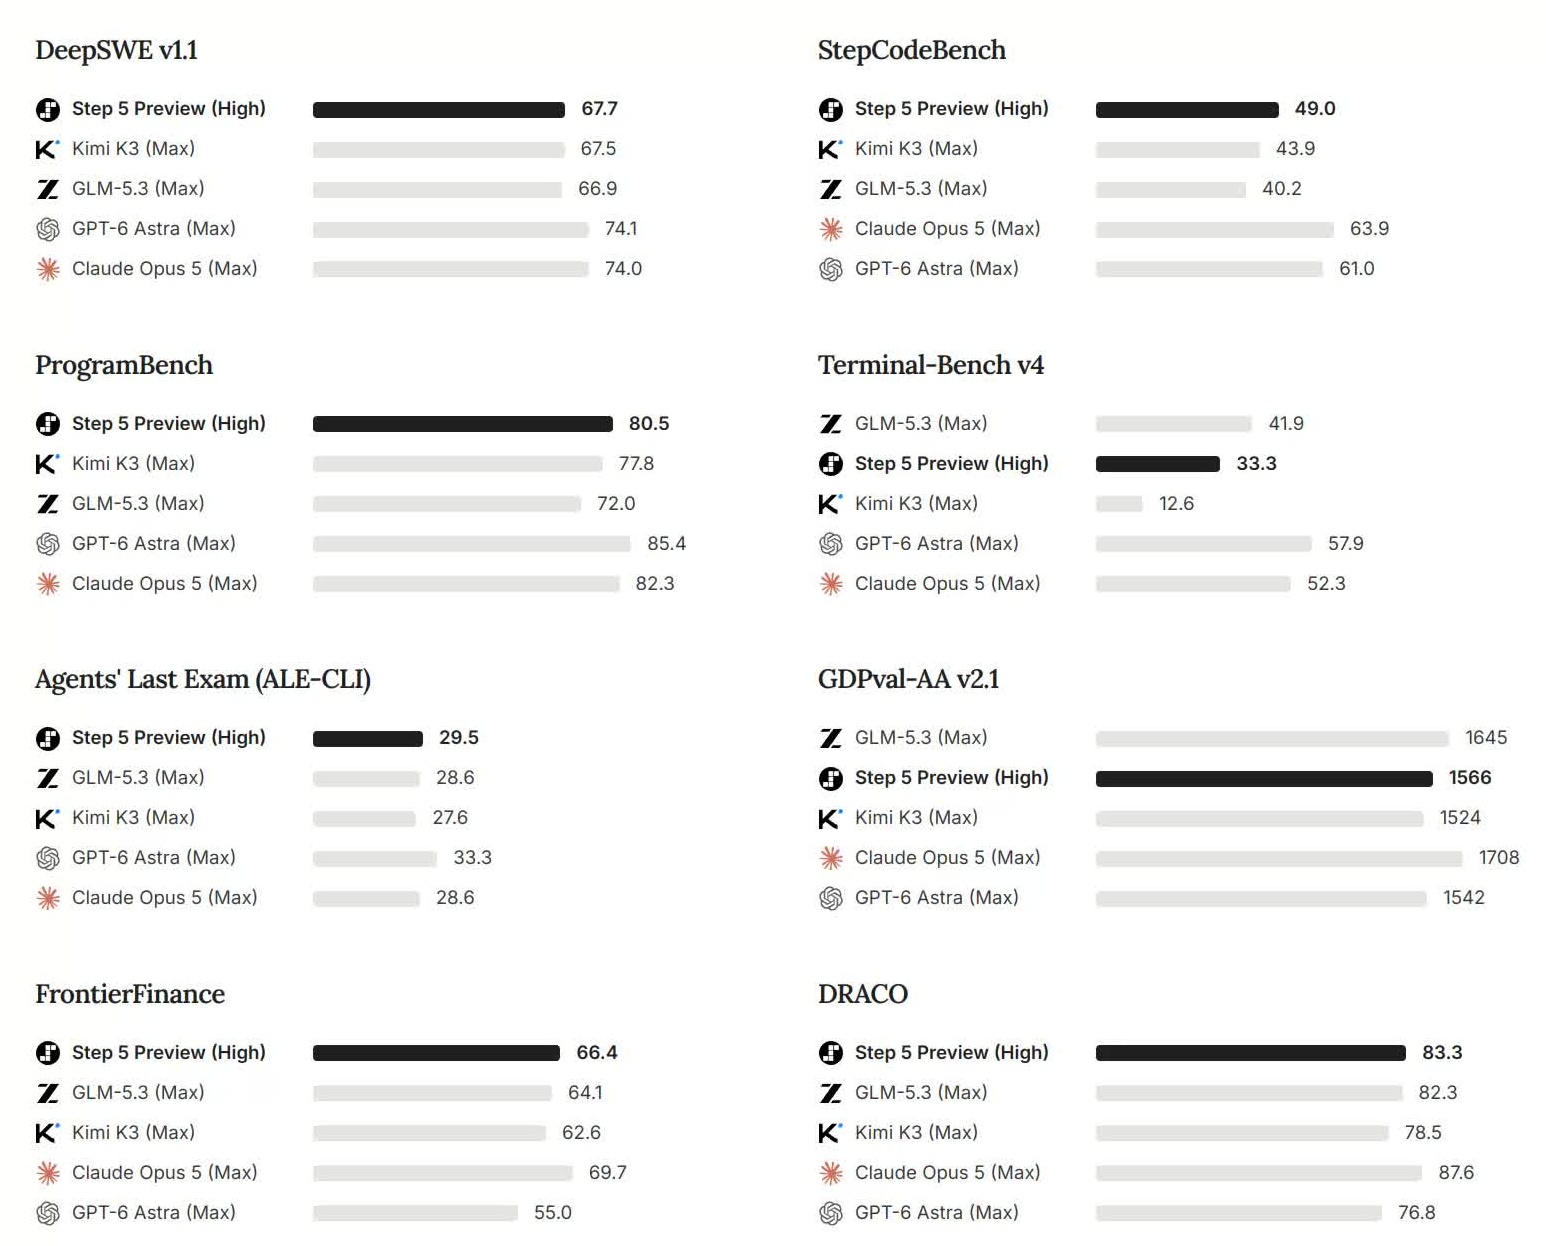
*上图来自https://www.stepfun.com/step-5-preview
针对Step 5 Preview的核心能力特征,MTT S5000从硬件算力、软件栈到推理框架进行了全链路精准适配与调优:
▼ 混合注意力适配
针对 Step 5 Preview的混合注意力结构(3层512-token滑窗+1层全注意力),在SGLang-MUSA上完成了模型与稀疏注意力后端适配。全注意力层即CSA(Compressed Sparse Attention),以8 token为区域单元筛选top-512历史区域,滑窗层使用512 ring cache。同时还原了partial RoPE、QK-norm/RoPE融合路径,完成了TP8/EP8切分,打通了混合滑窗+稀疏注意力完整推理链路。
▼ 混合精度推理
MTT S5000原生支持FP8精度,推理过程中使用FP8 DeepGEMM加速矩阵运算。同时采用BF16+FP32混合精度策略,专家贡献在FP32累加后仅执行一次TP归约,降低了解码阶段的通信与中间张量开销。
▼ Decode专家派发优化
为Decode阶段的MoE定制了专属路径,单token单次读取路由ID生成紧凑专家元数据,避免逐专家扫描;将top-k采样融合为单个MUSA算子,保持乘加精度控制。为每个唯一的decode graph分配独立显存池,规避了顺序差异导致的输出生命周期异常。
▼ MTP3投机解码适配
完成了Step 5 Preview MTP3三层预测器适配,支持一次前向处理anchor+3个draft的校验,对齐原生算术逻辑实现贪心接受与回滚。配合MUSA decode graph与请求元数据复用,大幅降低了解码端主机侧开销。
▼ 多模态能力打通
完成了Vision Encoder与Projector的加载与接入,支持单图、有序多图的图文请求。Decode侧复用原有推理链路与MTP预测器,实现了多模态投机解码。
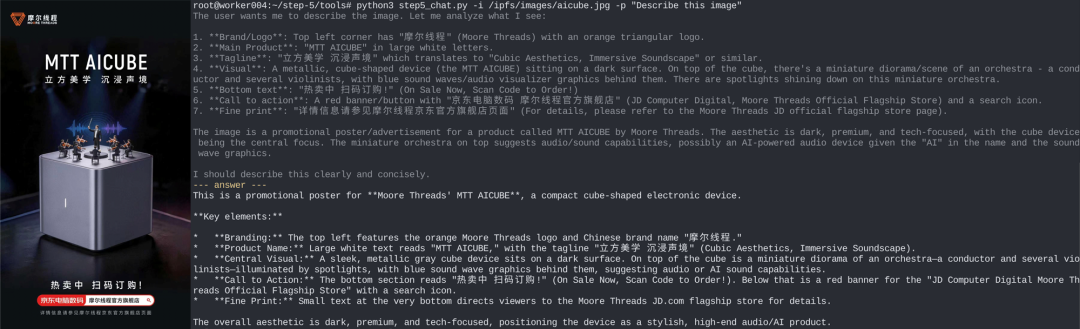
Step 5 Preview在MTT S5000上的多模态对话实测:模型准确描述输入海报
未来,摩尔线程将持续深耕MUSA软件生态,紧跟前沿大模型迭代节奏,让新模型“发布即适配”成为常态。依托全功能GPU算力底座,充分释放硬件潜能,为AI应用提供稳定高吞吐的推理能力,加速AGI技术的创新与产业化落地。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序