
台积电OIP二十年积淀,奔赴万亿晶体管时代
一颗芯片上集成一万亿个晶体管,是什么概念?这相当于把2015年全球所有芯片的晶体管总数,浓缩到一块手掌大小的硅片上。而台积电表示,这一天2030年就会到来。
在2026年的OIP论坛上,台积电提出了“智能革命”的新概念,改变了半导体行业只关注逐步改进的传统看法。这就像当年的工业革命用机器代替人类体力劳动一样,现在的AI正在帮助人们更好地发挥创造力。我们正在看到一种新的技术架构出现,它能让AI和人的想法快速互相反馈、互相促进,从而更高效地完成任务。
OIP:二十余年协作铸就的产业基石
开放创新平台(OIP)历经二十余年发展,已从最初的标准设计中心倡议,成长为半导体行业最具影响力的协作引擎。该平台如今已汇聚90家成员单位,横跨设计中心联盟、EDA联盟、IP联盟、云联盟、VCA联盟,以及3DFabric联盟六大专业联盟,形成了覆盖芯片设计全链条的生态网络。
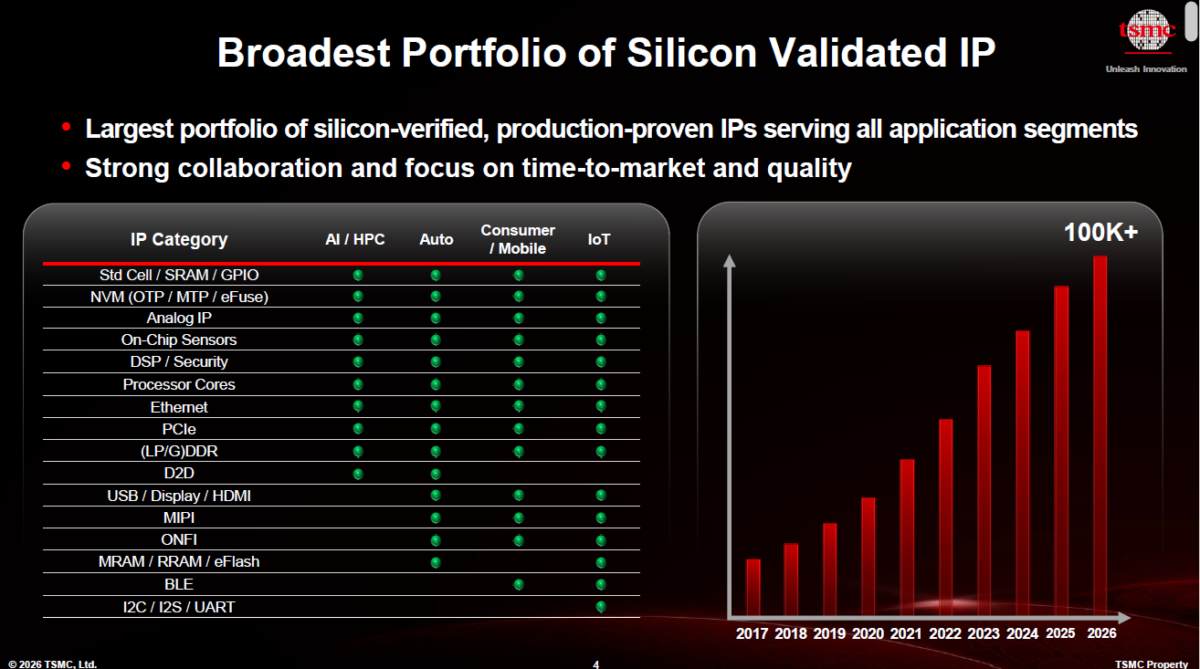
这一生态体系的规模,最直观地体现在其超过10万个经过硅验证、量产验证的IP核库上。这些模块不仅服务于超大规模云厂商,也日益面向“物理AI”领域,将先进智能能力迁移至物联网、汽车和边缘设备中。通过提供量产验证的基础模块,台积电确保通往万亿晶体管系统的瓶颈在于创意,而非IP验证的物理难题。
先进制程与3D封装:突破光罩极限
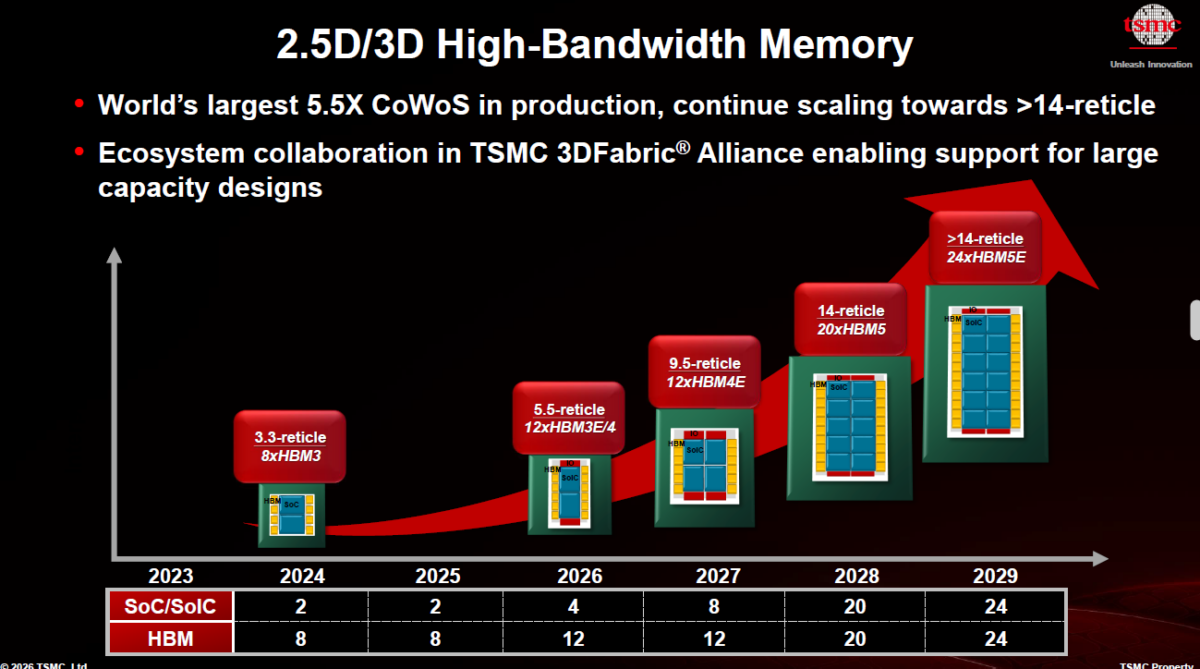
在AI时代,芯片制造不再依赖通用的标准化流程,而是转向更为激进的“设计-工艺”协同优化(DTCO)。通过同步精进工艺、标准单元库和设计流程,台积电从当前N3P节点到未来A14架构可实现2.3倍能效提升。而真正的突破在于绕过光罩尺寸极限:CoWoS平台正从3.3倍光罩扩展至超过14倍光罩的巨型封装,到2029年将支持24层HBM5E堆叠,得益于SoIC逻辑堆叠的复合效应。
得益于这一变革,相关增长数据将实现质的飞跃。从2024年的N7标准SoC到2029年的SoIC A14+A14堆叠,单个CoWoS封装里的晶体管数量将增长48倍。如果结合频率和功耗来计算,总算力更是会飙升87倍。这意味着,同等功耗下AI芯片有效计算能力将实现近百倍的增长。
下一代存储与互联:HBM5与硅光子
随着AI工作负载从大规模训练向“物理AI”和边缘端智能体推理迁移,存储架构必须更高效。台积电对SK海力士、美光和三星在HBM5标准制定中的紧密协作给予了高度评价,通过引入台积电先进的N3P工艺制造HBM5基础裸片,其合作成功实现了单位能耗带宽翻倍,显著提升了能效表现。
在互联方面,台积电COUPE光子引擎平台正在应对“互联墙”挑战,通过共封装光学器件和微环调制器,将带宽密度从当前的200Gbps向2030年的4Tbps/mm推进,有望从根本上解决AI集群的数据传输瓶颈。
“以AI造AI”:智能体设计的范式转变
台积电提出的最深刻的转变是“良性循环”的形成:用AI设计更好的芯片,更好的芯片又驱动更复杂的AI模型。台积电正在推动从传统以人为中心的PDK向TSMC ADK(AI设计套件)转型,这是一个多智能体框架,AI能从技术学习层自主学习,并自动编排设计工作流。
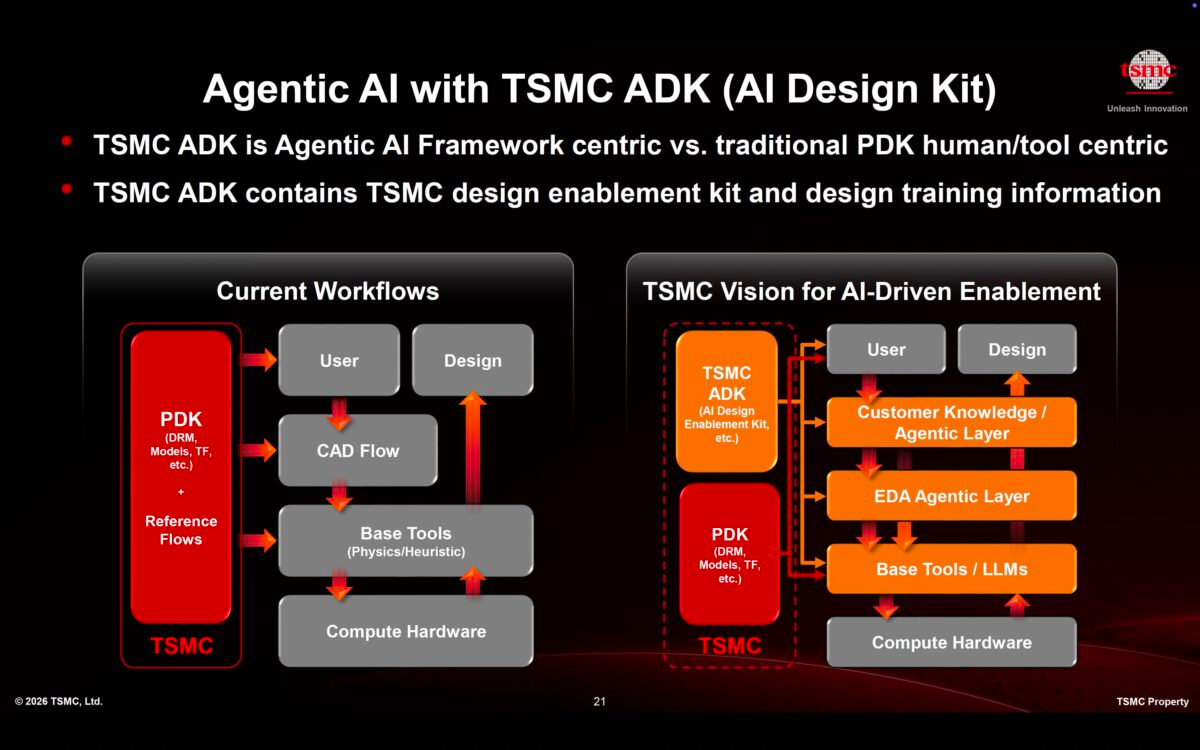
基于这套框架,行业发展成效显著。在数字设计领域,Cadence InnoStack和Synopsys AutoPilot使布局布线迭代效率提升3至5倍;在混合信号领域,Cadence ViraStack和Synopsys Custom Compiler Autopilot使设计迁移效率提升6倍。此外,OIP“新兴技术展区”还精选了六家AI驱动EDA和IP领域的初创企业,将“AI优先”的小型参与者纳入核心协作圈层。
系统级协同优化与未来展望
为支撑万亿晶体管架构,台积电通过STCO(系统-技术协同优化)将视野从单颗芯片扩展至整个机架,把AI SuperPOD视为单一设计单元,统筹计算、互联、存储、供电与散热。面对未来AI芯片巨大的发热量和供电需求,台积电不仅利用热DTCO技术进行散热管理,还通过将稳压器和多种高性能电容直接集成到芯片封装中,来确保持续稳定的电力供应。
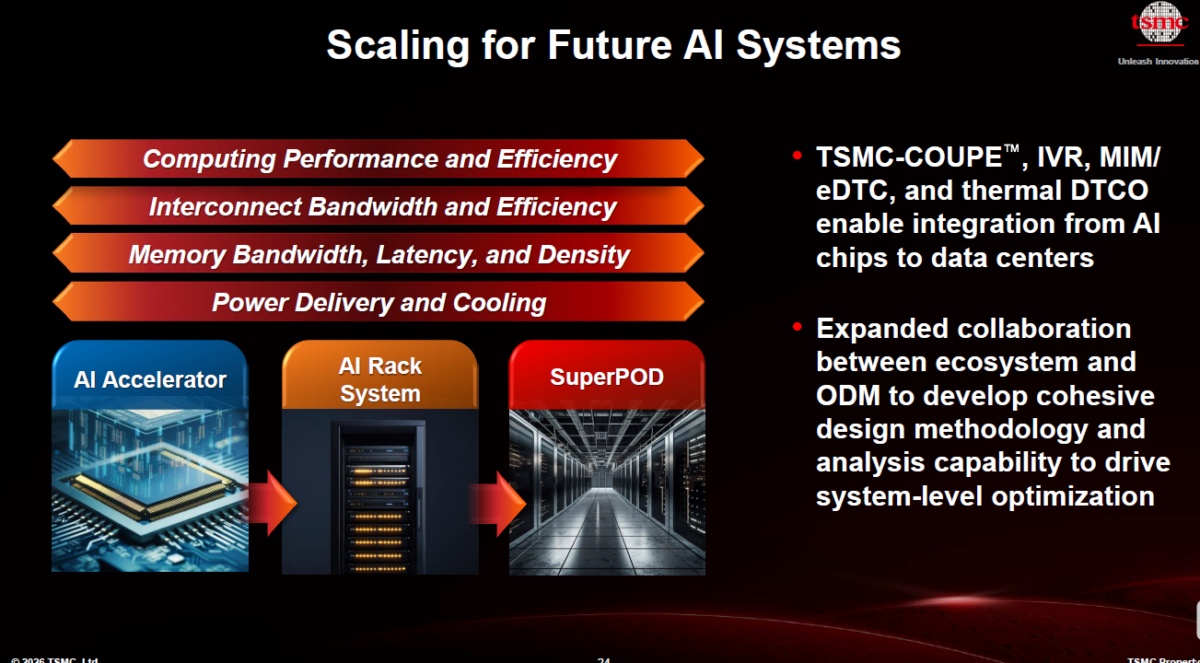
万亿晶体管时代建立在三大支柱上:持续的逻辑与封装创新、通过ADK实现的智能体设计加速,以及STCO驱动的系统级优化。随着OIP生态迈入第三个十年,智能体设计流程与大规模3D集成的结合,标志着一代人以来最重大的架构拐点。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序