
测评|英伟达CPU,异军突起
英伟达的 Vera 服务器芯片旨在实现极高的单核性能。其 Olympus 核心采用大规模乱序执行结构,并利用高时钟吞吐量在多核心服务器芯片中实现这一目标。然而,核心设计只是成功的一部分。非核心内存访问会严重影响核心性能,而更高的核心数量也会使互连设计更加复杂。为 Vera 的 Olympus 核心提供数据的任务落在了英伟达第二代可扩展一致性架构(SCF)上。SCF 的作用类似于 Arm 或英特尔的网状互连,它作为一个大型芯片级网络,连接核心、缓存和片外 I/O。与英伟达 Grace 芯片中使用的第一代 SCF 一样,Vera 的 SCF 可能也采用了网状拓扑结构。
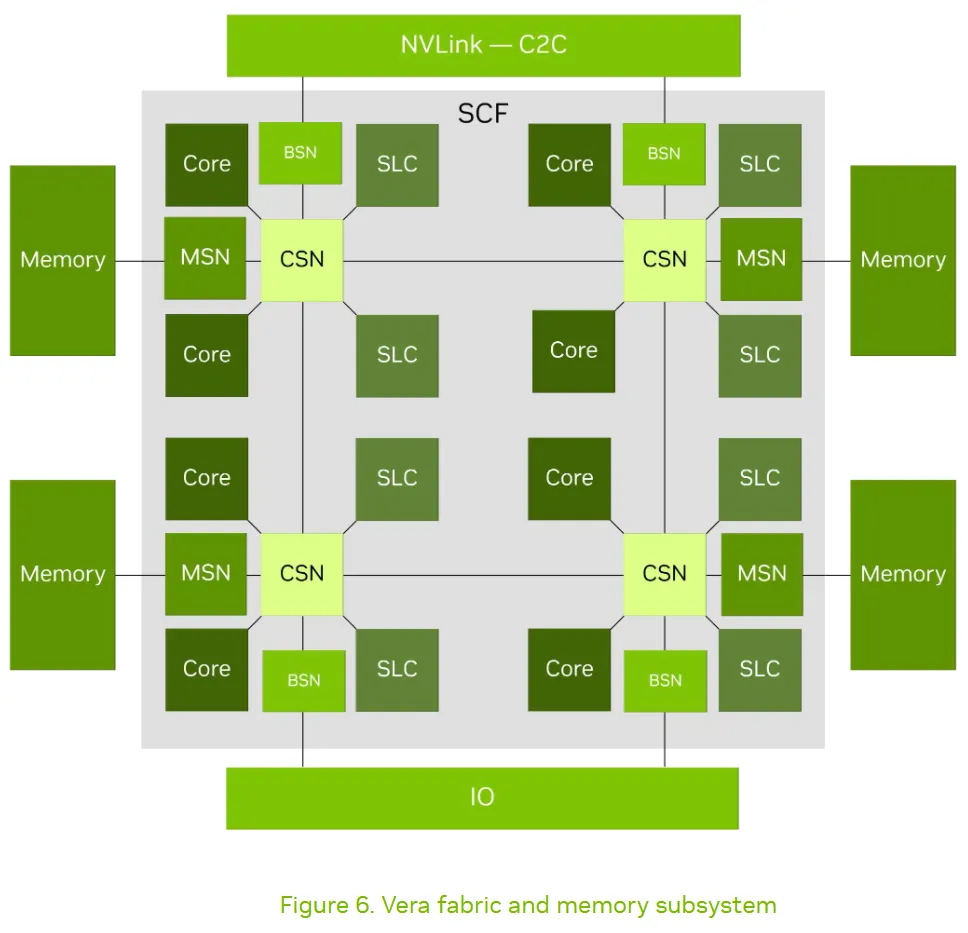
英伟达白皮书中的SCF组件图
SCF 由多种节点类型构成。一致性交换节点 (CSN) 承载着核心和缓存,其作用类似于英特尔的网状交换节点。与英特尔的网状交换节点不同的是,英伟达的每个 CSN 都承载一对核心。这样做有助于控制节点数量,安培架构的 Altra Max也采用了类似的策略。安培架构使用 Arm 的 CMN-600 芯片,每个完全一致性请求节点 (RN-F) 都承载一个 Arm DynamIQ 共享单元 (DSU),其中包含一对 Neoverse N1 核心。
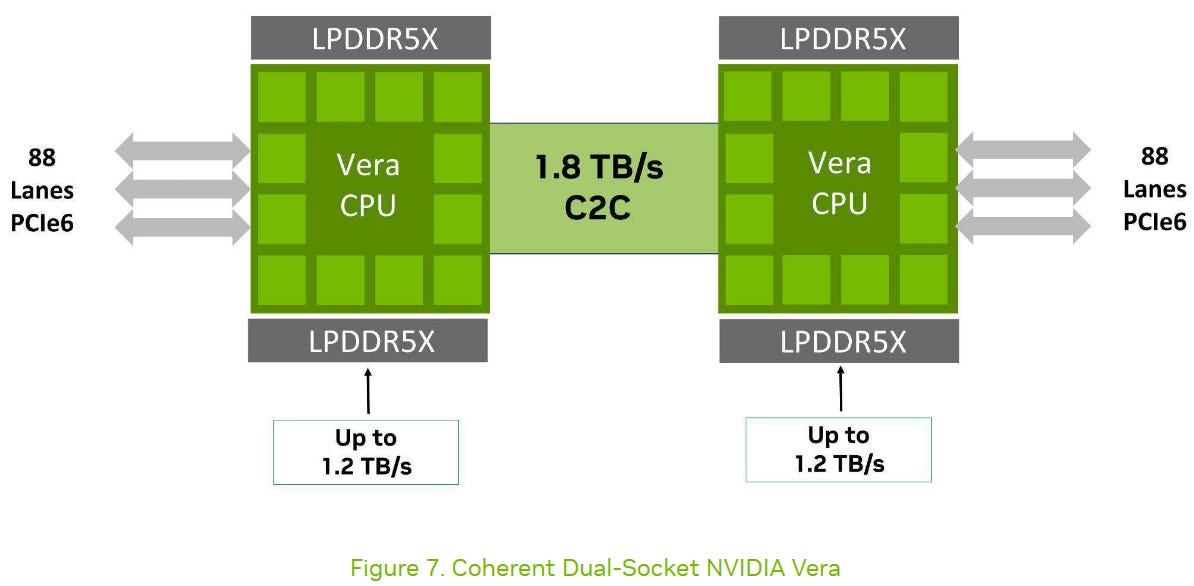
内存交换节点 (MSN) 充当 SCF 和 Vera 的 LPDDR5X 内存控制器之间的桥梁。Vera 采用 1024 位 LPDDR5X-9600 配置,因此 MSN 可提供高达 1.228 TB/s 的带宽。桥接交换节点 (BSN) 承载 PCIe 控制器和跨插槽链路。Vera 拥有 88 条 PCIe 通道,可为外围设备提供 665.5 GB/s 的带宽。NVLink C2C 作为跨插槽链路,提供 1.8 TB/s 的理论带宽。
带宽,海量带宽
Grace服务器采用LPDDR5X内存,在服务器领域开创了先河,但与同类产品相比,其DRAM性能平庸。Grace的内存延迟高达200纳秒以上。虽然Grace的内存带宽绝对值尚可,但与当时基于DDR5的服务器芯片相比略显不足。Vera彻底改变了这一切。其1024位LPDDR5X接口赋予了Nvidia服务器芯片超越同类产品的带宽。延迟问题也得到了解决,现在可以与基于DDR5的系统相媲美。Vera还采用了SOCAMM2模块,使其内存系统支持现场维护和升级。相比之下,Grace采用的是焊接式内存,因此内存芯片故障可能会造成严重问题。
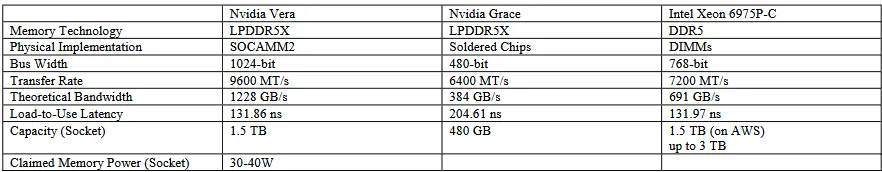
Vera 在带宽负载不断增加的情况下,仍能保持出色的延迟控制。即使其他线程已接近芯片的内存带宽极限,指针追踪线程的延迟也不会超过 200 纳秒。而其他服务器平台则呈现出更为明显的“曲棍球棒”曲线,即随着带宽负载接近内存控制器的极限,延迟会急剧上升。
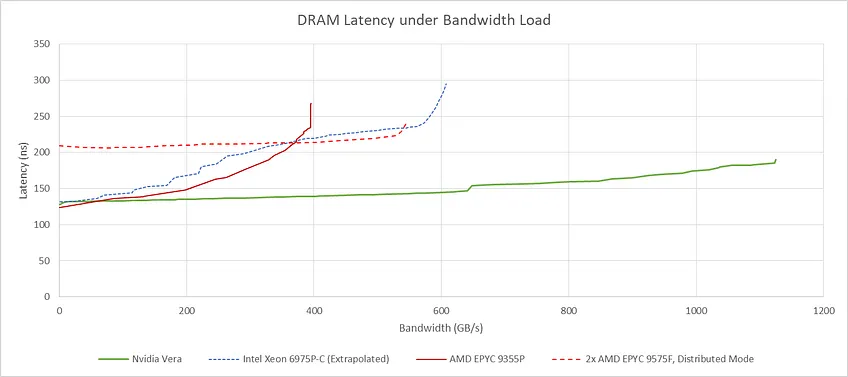
通过对英特尔至强6处理器进行外推,将单个芯片的性能结果乘以3,即可估算出芯片级带宽。
英伟达凭借其高带宽和低负载延迟的优势,应该能比其他服务器更好地控制噪声邻域效应。换句话说,即使核心数较少,Vera 在 DRAM 密集型工作负载方面也能超越其他芯片。
L3缓存
即使是容量巨大的 LPDDR5X 子系统也无法满足所有程序内存访问的需求,因此 Vera 像其他高性能 CPU 一样,通过大容量缓存来解决内存瓶颈问题。Vera 的缓存策略与其他大型网状架构类似。所有核心共享一个 164 MB 的 L3 缓存,并与核心私有的 L2 缓存保持非包含关系。
如果 L2 缓存中不存在数据重复,这种配置可以使 Vera 的有效末级缓存容量高达 340 MB。对于不同核心频繁访问的地址,L3 缓存可以通过在共享地址处仅保留一份数据副本来节省缓存容量。Vera 的 L3 读取带宽约为 3.35 TB/s,即每个核心 33.1 GB/s。单个核心在没有与其他核心争用的情况下可以达到 88.5 GB/s 的读取速度,因此 33.1 GB/s 的读取速度明显下降。然而,从绝对意义上讲,这仍然是一个合理的带宽量,而且很可能足够了,因为 2 MB 的 L2 缓存应该会降低 L3 带宽需求。
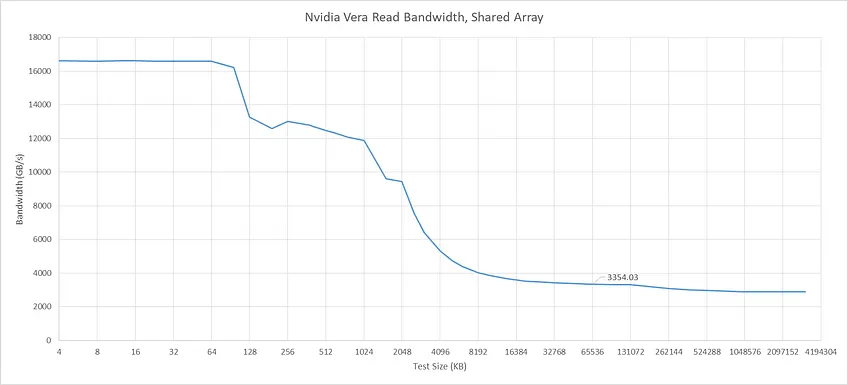
英伟达的缓存策略与AMD的截然不同,AMD强调芯片整体的缓存容量,同时提供极高的L3缓存带宽。例如,AMD的Genoa-X芯片单核L3缓存带宽可达90 GB/s,即使芯片上的所有核心都满负荷运行时,带宽也仅会降至85 GB/s。将Genoa-X(以及其他AMD服务器芯片)划分为八核集群意味着每个L3缓存实例只需为八个核心提供高带宽。Genoa-X的1248 MB L2+L3缓存容量对于主要处理线程私有数据的多线程应用程序,或者并行运行多个不同作业的应用程序来说,也是有利的。
然而,对于线程间共享大量数据的工作负载,由于共享数据可能在多个L3缓存实例中重复存储,因此可能会造成缓存容量利用效率低下。最后,在 Genoa-X 上,单个线程只能分配到其 96 MB 的 L3 实例中,而 Vera 理论上可以让一个线程使用其全部 164 MB 的 L3。
十字插销
NVLink C2C 作为插槽之间的点对点链路,使 Vera 能够扩展到双插槽配置。双插槽 Vera 系统有两个 NUMA 节点,每个节点代表一个插槽及其直接连接的内存。跨节点内存访问的加载到使用延迟为 309.27 纳秒,比本地内存访问高出 177.41 纳秒。
令人惊讶的是,要达到 309.27 纳秒的延迟,需要在链路上产生数十 GB/s 的带宽。单独运行的指针追踪测试测得的延迟超过 370 纳秒,这表明 NVLink C2C 只有在带宽需求足够大且请求开始积压时才会切换到更高性能状态。
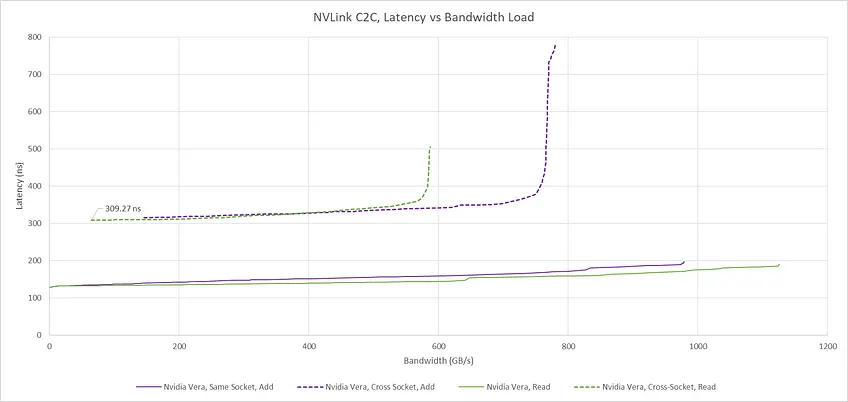
NVLink C2C 为跨路链路提供了极高的带宽。读取速度可达 587 GB/s 以上,而双向读写模式下的读取-修改-写入速度可达 780 GB/s。Vera 不仅拥有比我所知的任何其他双路配置都更高的跨路带宽,甚至超过了大多数服务器直接连接内存的带宽。然而,NVLink C2C 在延迟方面却略逊一筹。
相比之下,AMD 的 Genoa-X 在跨路内存访问方面,加载到使用延迟仅为 222.7 ns。Vera 对 NVLink C2C 延迟的控制也不如对本地 DRAM 访问那样精准。在高带宽需求下,延迟会急剧上升,有趣的是,当使用读写模式实现 780 GB/s 的跨路带宽时,延迟竟然达到了 780 ns。
核心间延迟
互连必须提供一致的内存视图,使核心的写入操作全局可见,即使写入的数据可能仅存在于该核心的私有缓存中。“核心到核心”延迟测试使用原子操作在两个线程之间传递一个值,并在同一插槽中的核心对上测量出平均延迟为 148.5 纳秒。延迟范围从 87.5 纳秒到 199.3 纳秒不等,具体取决于被测核心对以及被测缓存行的所有者。SMT 同级线程的延迟小于 10 纳秒,这表明核心可以在不涉及速度较慢的跨核心互连的情况下,在其 SMT 线程之间保持数据一致性。
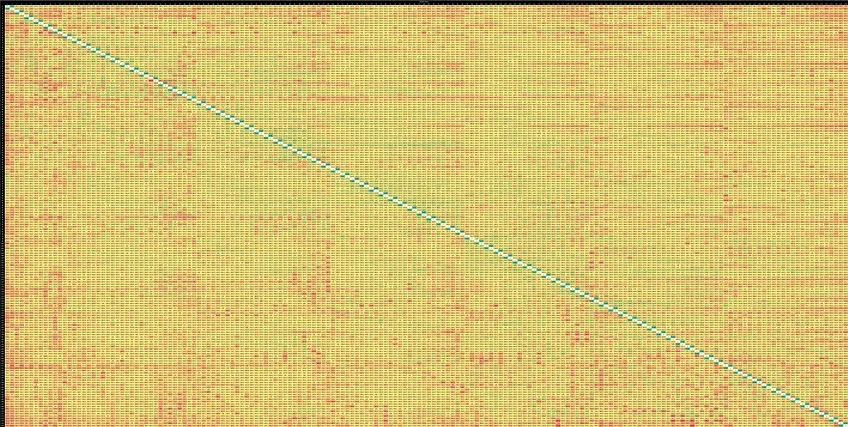
同一插槽内的核心间延迟,核心编号已重新调整以匹配 Windows 的命名规则。实际的核心编号顺序为:插槽 0 中的第一个逻辑线程,插槽 1 中的第一个逻辑线程,插槽 0 中的第二个逻辑线程,插槽 1 中的第二个逻辑线程。
不同插槽上的核心间延迟约为 660 纳秒,这确实偏高。我记得 Anandtech 在双插槽 Ampere Altra 系统中也测量过类似的数值,但超过 600 纳秒的延迟并不常见。
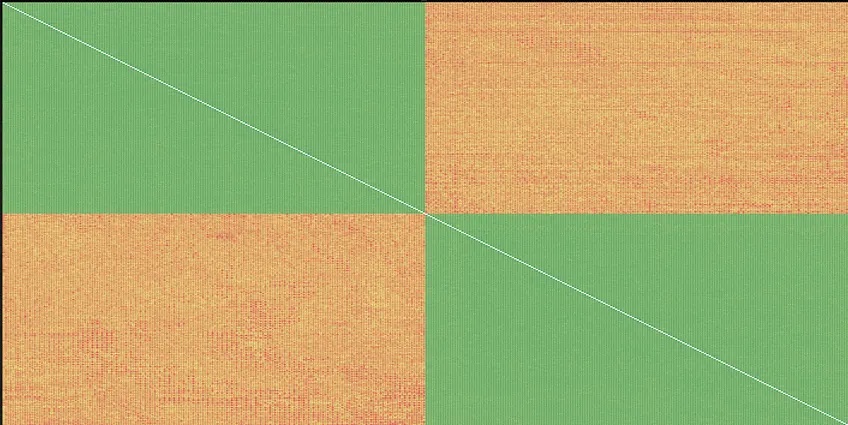
系统级核心间延迟,核心编号已重新调整以匹配 Windows 方案。
AMD 的 Genoa-X (EPYC 9V33X) 实现了更低的跨平台核心间延迟,约为 209 纳秒。亚马逊的 Graviton 4 表现更佳,其跨平台延迟与更老款、核心数量更少的处理器相当。
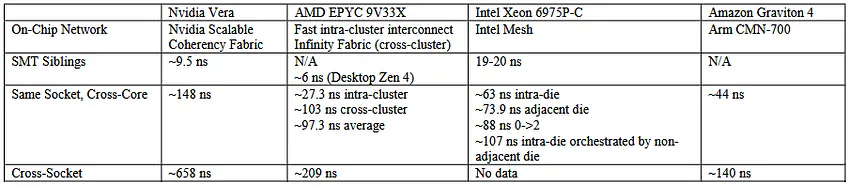
Vera的插槽内延迟表现稳定,与Nvidia白皮书中提到的优势相符。然而,其延迟也始终较高,甚至比Nvidia之前的Grace芯片还要差。平均而言,它也逊于亚马逊的Graviton 4和AMD的Genoa-X。
计算吞吐量:SPEC CPU2026
SPEC 的 CPU 性能测试套件可以通过运行每个工作负载的多个副本来测量吞吐量。当每个硬件线程运行一个副本时,Vera 轻松超越了 Graviton 5 的节点性能。不出所料,Vera 也优于核心数较低的 Zen 5 处理器,该处理器配置特殊,使用一个 NUMA 节点跨越了两个插槽。
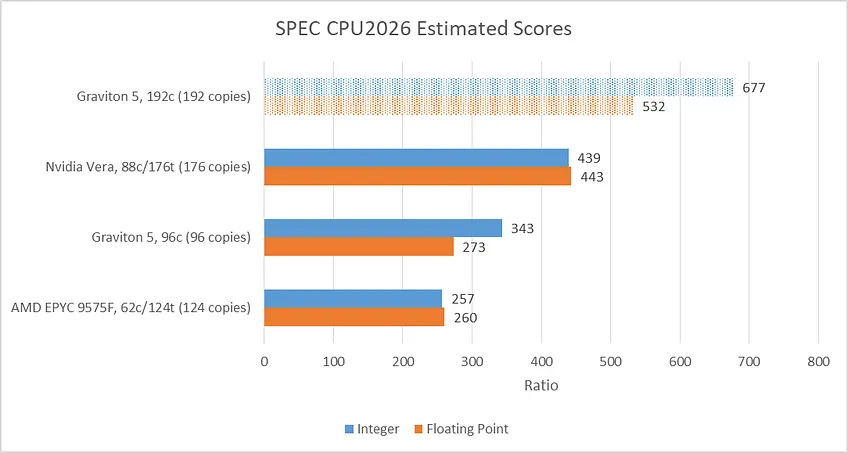
然而,Vera 在插槽层面落后于 Graviton 5。虽然这种比较并不完全公平,因为 Graviton 5 无法将整个插槽作为一个独立的 NUMA 节点开放,但这确实体现了核心数量和更高性能核心之间的权衡。采用低性能核心的密度优化设计通常可以提供更高的吞吐量,前提是有足够的工作负载来充分利用所有核心。SMT 技术有助于缩小差距,但 Vera 仍然难以与核心数量超过其两倍的设计相匹敌。
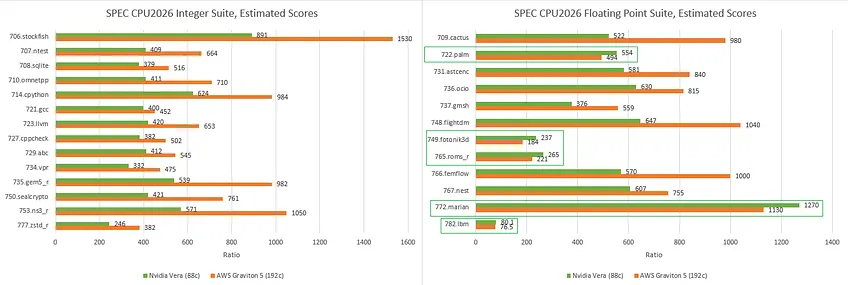
即使在对内存带宽要求较高的工作负载下,Vera 在同平台对比 Graviton 5 时仍然具有优势。例如,即使在 Ryzen 7 9800X3D 上运行单个 749.fotonik3d 程序,它也往往会占用大量的 DRAM 带宽。
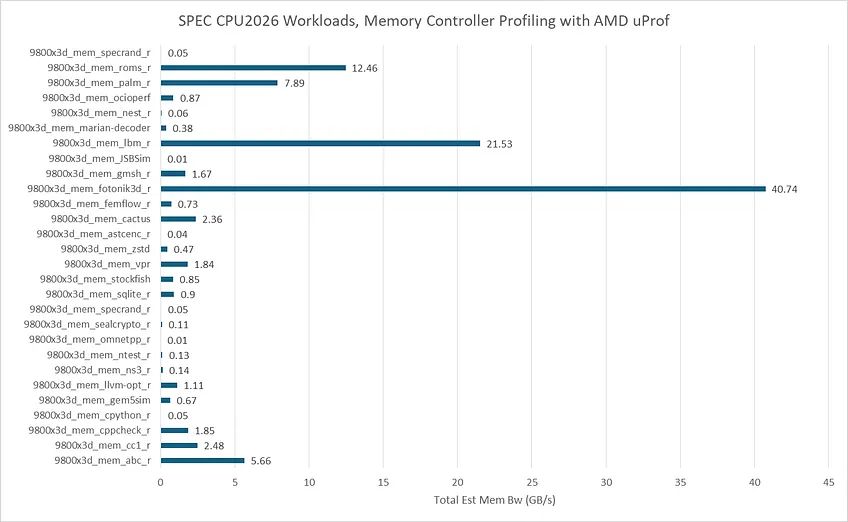
使用 AMD uProf 软件,针对 UMC(统一内存控制器),在 Ryzen 7 9800X3D 上运行 SPEC CPU2026 工作负载,并运行单个副本,收集数据。
虽然没有收集 Vera 和 Graviton 5 全插槽运行的性能监控数据,但可以肯定的是,对于这两款芯片而言,749.fotonik3d 测试都受限于 DRAM 带宽。运行多个副本意味着每个副本的平均缓存容量会减少,并且每个副本的带宽需求会叠加。尽管 Vera 的核心数量远低于 Graviton 5,但在 749.fotonik3d 测试中,其性能仍比 Graviton 5 高出近 20%。这一优势也体现在其他几项 SPEC CPu2026 浮点运算测试中。另一方面,Graviton 5 在对缓存更友好的工作负载中则拥有压倒性的优势。
结语
Vera 是当今服务器领域极具竞争力的产品,其单核性能卓越,并拥有巨大的内存带宽。与英伟达之前的 Grace 芯片相比,Vera 更具优势。Grace 芯片的缺点在于其仅有 1MB 的 L2 缓存,且 L2 缓存未命中延迟非常高。与其他 Arm 甚至 AMD 和 Intel 的服务器芯片相比,Vera 牺牲了部分核心数量,换取了更高的单核性能。在需要快速完成单个任务且工作负载可能不会充分利用所有核心的应用场景中,Vera 将难以被超越。
对于整个Arm服务器领域而言,Vera的加入无疑带来了令人欣喜的多样性提升。Arm最初进军服务器市场时,其芯片的竞争主要依靠核心密度。像Neoverse N1这样的核心无法与AMD或Intel的同类产品正面抗衡,因此像Ampere Altra这样的芯片只能通过提供更高的核心数量来与之竞争。如今,Arm服务器芯片仍然在核心密度方面与AmpereOne等芯片展开竞争,但基于Arm Neoverse V系列核心的芯片已经拓展了Arm的边界。Vera则在单核和单线程性能方面进一步突破了这一边界。服务器领域的多样性和竞争的加剧始终是一件好事,而Vera的强势表现预示着未来会有更多精彩产品问世。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序