近内存计算,能否解决AI内存瓶颈?
把数据处理放在离内存更近的位置并不是新想法,但韩国初创企业Xcena认为,借助CXL(Compute Express Link)协议,他们找到了更优的实现方案。MX1是一款CXL Type 3设备,最多可搭载2TB DDR5、由SSD支撑的InfiniteMemory容量,以及超过1000个定制RISC-V内核。首席产品官Harry Kim表示,在部分数据分析负载下,Xcena的MX1吞吐量最高可达通过CXL传输数据的主机CPU的4.7倍,能效提升至18.7倍。
在接受访时,Kim称内存瓶颈不能只靠增加内存容量解决,必须更高效利用现有内存资源。“如果我们能减少数据搬运,将会带来很大帮助。”
Kim介绍,MX1非常适合内存密集型AI和数据库负载,这类场景里只有一部分存储数据最终需要由CPU或GPU处理。他表示,向量检索、KV缓存、数据库过滤这类应用中,在内存附近完成计算,可以降低延迟、减少功耗、缓解带宽瓶颈。“以数据库场景举例,我们可以提前过滤掉CPU不需要读取的老旧数据,减少数据搬运。”
对于AI场景,这意味着只提取KV缓存里需要的那部分数据片段。Kim称,要整合DDR5、SSD与RISC-V内核,需要攻克大量软件与内存管理难题,Xcena希望MX1能方便客户开发使用。“我们希望内存模型尽可能贴近客户在CPU侧的使用习惯。”
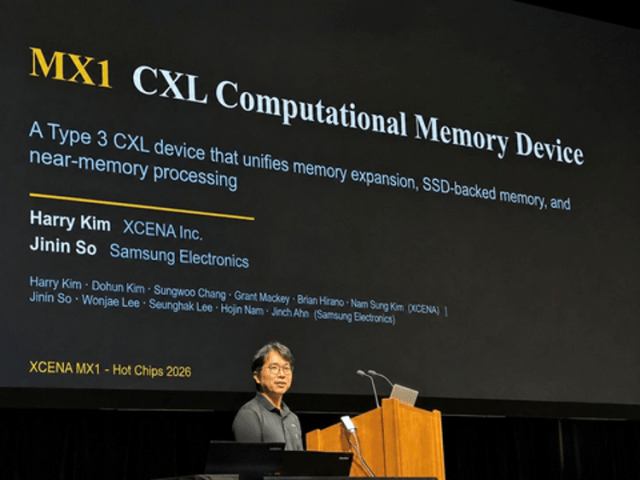
他提到最大技术难点之一,是搭建一套统一虚拟内存系统,维护主机内存、设备内存与SSD存储之间的地址映射关系。
Xcena对MX1的核心定位首先是高性能内存扩展器。Kim说,它和其他CXL内存扩展产品的差异在于,集成了全功能内存控制器,同时具备专用近内存计算能力。其他带计算能力的CXL设备采用通用处理器,而MX1面向并行数据处理,充分利用内部全部带宽。
该设备的计算能力基于众核RISC-V架构。Kim表示,选择RISC-V是看中其成熟的生态。公司修改了基于LLVM的编译器,支持自定义指令,还提供类似CUDA的软件开发套件,开发者可以使用C、C++ 或Rust语言进行开发。
管理数千个处理器内核难度很高,Xcena借鉴分布式数据库系统开发了一套开发框架,简化编程与任务调度。
Xcena已经向内存厂商、CPU厂商以及超大规模云厂商送出MX1原型样片;公司计划2026年底实现量产,目标在2027年产生首批客户收入。
Kim表示,该方案能否落地,关键取决于行业更大范围普及基于PCIe 6.0的CXL 3。CXL的普及速度确实低于预期,但他认为问题不在技术本身,包括英伟达在内,所有CPU、GPU厂商都已经在芯片内集成CXL。
Kim认为CXL本身已经成熟,但其价值仍待验证。想要大规模落地,还需要完善更广泛的生态。“我们需要证明,搭载CXL 3的AI基础设施,能让所有参与方获益。”
Objective Analysis首席分析师Jim Handy在接受采访时评价,Xcena的MX1架构组合很有意思,思路和计算存储相近。“这是一款很有看点的产品。”
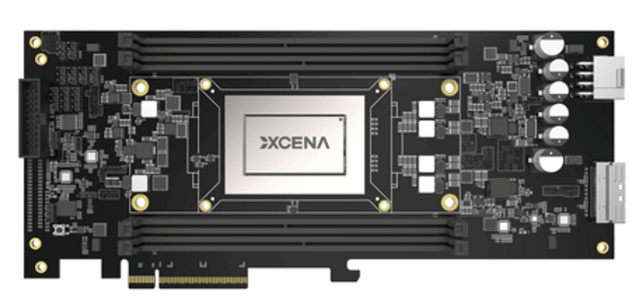
Xcena的MX1原型计划2026年底量产,预计2027年获得首批客户收入。
一份名为《CXL Market Now Taking Shape》的Objective Analysis报告指出,CXL正在超算云厂商群体中逐步落地,这项技术有望迎来高速增长。
Handy称,当前CXL最有吸引力的能力是内存扩展;用DDR4这类旧内存复用,而不是按现价采购DDR5,已经成为一种常见落地场景。他举例,Meta在数百万台服务器中复用退役服务器拆下的DDR4内存,而不是直接报废。CXL的内存池化能力虽然理念很好,但还没有大规模落地。“负责研发内存池化技术的团队压力不小。这项技术可以提升现有内存芯片的利用率。如果内存价格高昂,企业肯定不希望内存资源闲置。”
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。




联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)
半导纵横公众号
半导纵横小程序