
开发者把CUDA转接到AMD HIP,Windows原生跑通CUDA独占负载
AMD 在 Windows 上的官方软件栈近年持续补齐,但只认 CUDA 的老旧仓库与专用工具仍是空白。一名开发者用一套可复现的 PowerShell 脚本,把 ZLUDA 翻译层与 AMD 面向 Windows 的 HIP SDK 装配到一起,在 Radeon RX 9060 XT 上端到端训练了一个约 222 万参数的强化学习网络,全程没有虚拟化,也没有双系统。
官方路线补上了,CUDA 独占软件补不上
随着最新一轮 ROCm 更新,AMD 把官方的 PyTorch 与 HIP SDK 支持带到了 Windows 消费级显卡,覆盖 Radeon RX 7000 与 RX 9000 系列。对这类原生受支持的框架而言,AMD 显卡在 Windows 上才算真正可用。官方兼容矩阵也显示,Windows 侧目前只提供 PyTorch 支持,TensorFlow、JAX 与 ONNX Runtime 仍限 Linux。
缺口留在另一边。那些只认 CUDA、拒绝其他后端的闭源应用、老旧仓库与专用 AI 工具,依然无法直接在 AMD 显卡上运行。GitHub 上的 Speedstu 项目 CUDA-for-AMD-Windows 针对的正是这一类负载,它证明在 Windows 上、不借助虚拟化或双系统,也能在 AMD 硬件上跑通这些程序。
这个项目没有发明新的运行时。它的做法是在 ZLUDA 与 AMD 面向 Windows 的原生 HIP/ROCm SDK 之间搭桥。ZLUDA 是一个翻译层,负责接管应用发出的 CUDA 驱动调用,再转发到 AMD 的 HIP/ROCm 栈上;应用二进制不需要重新编译,也不需要知道自己跑在什么硬件上。
真正稀缺的不是翻译层本身,而是围绕它的可复现性。让 ZLUDA、特定版本的 AMD 驱动、Windows HIP SDK、ROCm 数学库与一份 CUDA 版 LibTorch 在版本上达成一致,正是这类尝试通常失败的地方。项目把各组件锁在清单文件里,自动下载、校验哈希、跑兼容性测试,最后的结果要么可用,要么明确指出缺了哪个库。
安装脚本会自动识别 GPU 架构与原生 gfx 目标,校验驱动、HIP SDK 与所需的数学库,下载锁定版本的 ZLUDA(v6-preview.69)与 LibTorch 2.3.0+cu118(约 2.66GB),校验 SHA-256,生成运行时配置,并调用 ZLUDA 自带的 cuda_check.exe 做一次检测。运行阶段由启动脚本把所需的兼容性 DLL 放到目标程序旁,并为当次运行配置 HIP/ROCm 路径。
覆盖了什么,没覆盖什么
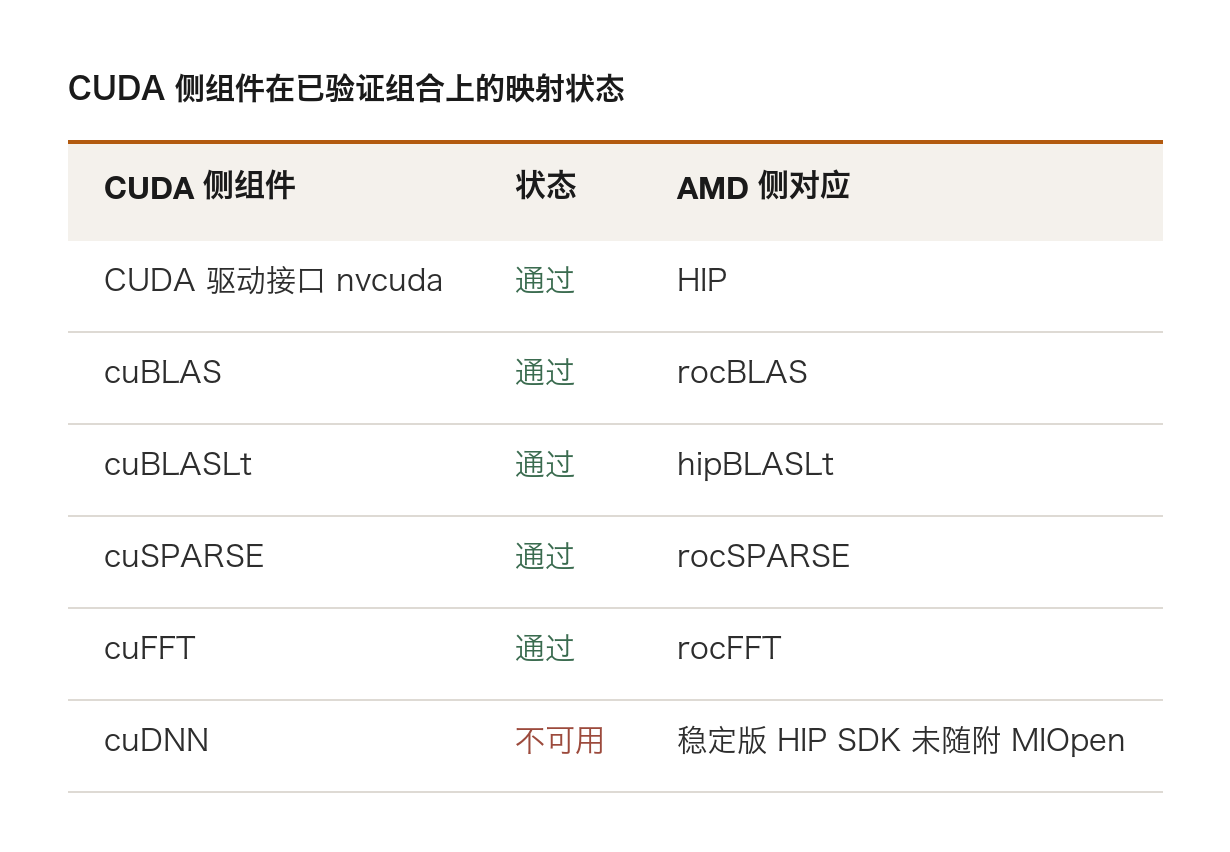
在已验证的这套组合上,被接管并映射到 AMD 侧实现的组件如下。
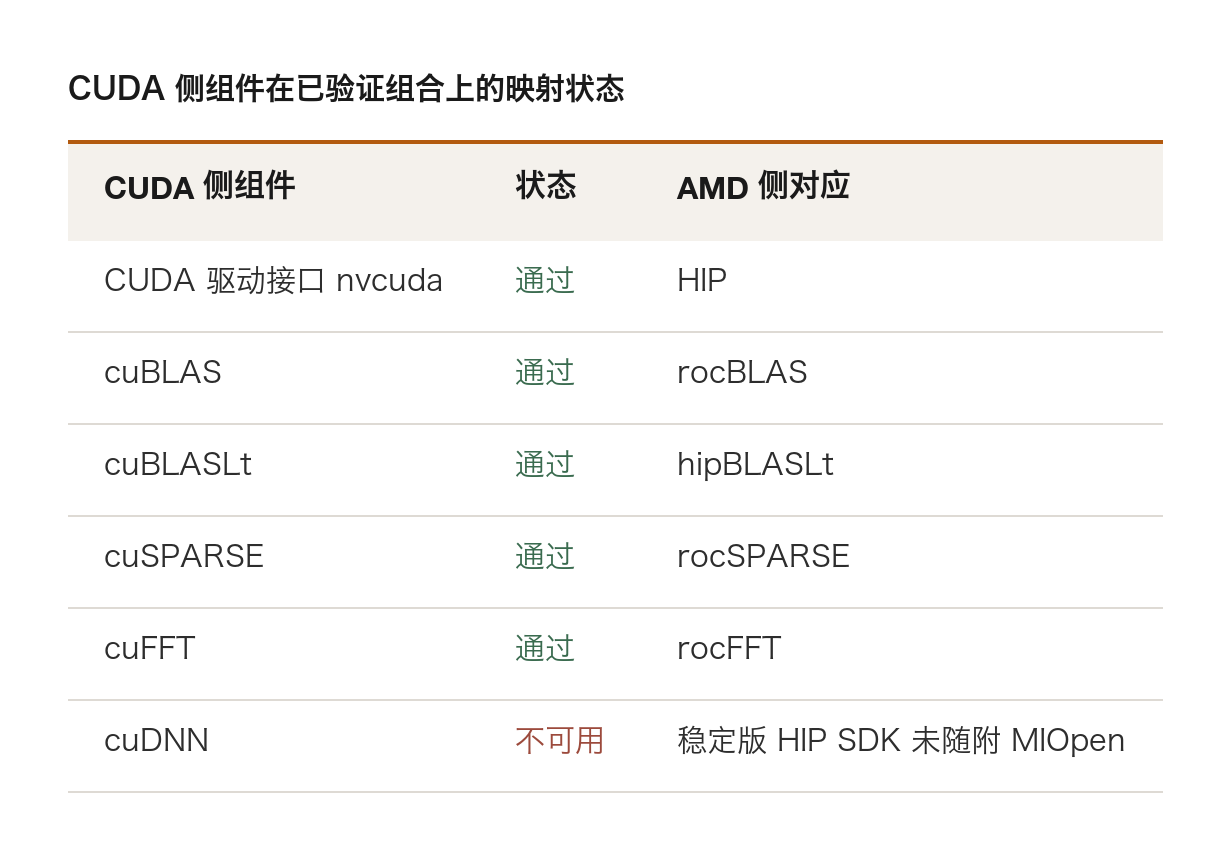
cuDNN 这一项是分水岭。稳定版 Windows HIP SDK 没有提供完整的 ROCm AI 库栈,例如 MIOpen,因此依赖卷积算子的软件可能需要更新的 nightly HIP 栈,或者额外改造。项目作者的说法是,稠密矩阵乘与 GEMM 占主导的 LibTorch 训练不一定依赖 cuDNN,验证用的 PPO 负载就是在没有 cuDNN 的情况下跑完的。此外,NCCL、TensorRT 与部分自定义 CUDA 扩展也可能失败。
概念验证的负载是一个 2,216,347 参数的 PPO 网络,通过 CUDA 版 LibTorch 训练,跑在 Radeon RX 9060 XT 上(gfx1200,RDNA 4)。单次验证迭代处理 65,536 个时间步。项目文档提到,这套负载正是当初催生整个项目的那个用例。
下图是一次受控 A/B 测试的结果,在同样的显卡与负载上对两套运行时各跑 10 次迭代,每个试点丢弃第一次作为预热。
公共上游路径只依赖官方发布的 ZLUDA 与 AMD 原版 HIP SDK 6.4,吞吐更快,因此成为默认选项。那个可选的自定义覆盖层由复原的旧版 DLL 拼成,项目不发布二进制文件,理由是原始包装层来源不完整,且复原出的 HIP 运行时含第三方 AMD 二进制,只在清单里留下哈希指纹。
不同训练配置下的历史调优运行曾达到约 7 万至 10.9 万步/秒,与上表不可直接横向比较。测试者指出,后续一次改写把 LibTorch 与 ZLUDA 从 PPO 中移除,吞吐大幅提升,说明这组翻译层仍然存在性能损耗。
三个边界
第一,范围窄,这是单人维护的开源项目,不是企业级方案。目前只有 RX 9060 XT(gfx1200)通过验证;扫描脚本能识别其他 Windows HIP 架构家族,但一律标记为未经核实的候选机型,架构识别成功不等于负载能跑。cuDNN、TensorRT、NCCL 尚未解析,兼容性严格取决于具体负载,重度依赖 cuDNN 的 AI 工具在这套组合上跑不起来。
第二,ZLUDA 的维护状态。这条翻译链路 2020 年从英特尔 GPU 起步,英特尔 2021 年退出,AMD 于 2022 年出资推进、2024 年初终止资助,之后的匿名赞助方支持到 v6 发布,现已退出。v6 于 6 月 29 日发布,商业支持全部撤离,项目回到业余维护状态。作者本人的表述是,脱离商业资金约束之后,优先级回到了他个人更感兴趣的方向,包括 PhysX 支持与 Windows 加载机制。把生产任务押在这样一条链路上,风险并不小。
第三,许可风险,英伟达自 CUDA 11.6 起在用户许可协议中写明,不得对 SDK 组件生成的产物做逆向工程、反编译或反汇编,以将其翻译到非英伟达平台,2026 年 1 月的更新又强化了这则限制。这意味着在 AMD 硬件上通过翻译层运行 CUDA 二进制,在商业用途上触碰的是英伟达的条款,个人折腾与研究用途处在灰色地带。
这个仓库的价值在于,论证了在 AMD 显卡上运行只认 CUDA 的软件,卡住的不是硬件能力,而是翻译工程。重新编译源码始终是合规路径,AMD 也提供了把 CUDA 代码迁移到 HIP 的工具链;翻译层解决的是拿不到源码的那批二进制。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序