
光子芯片首次运行大语言模型
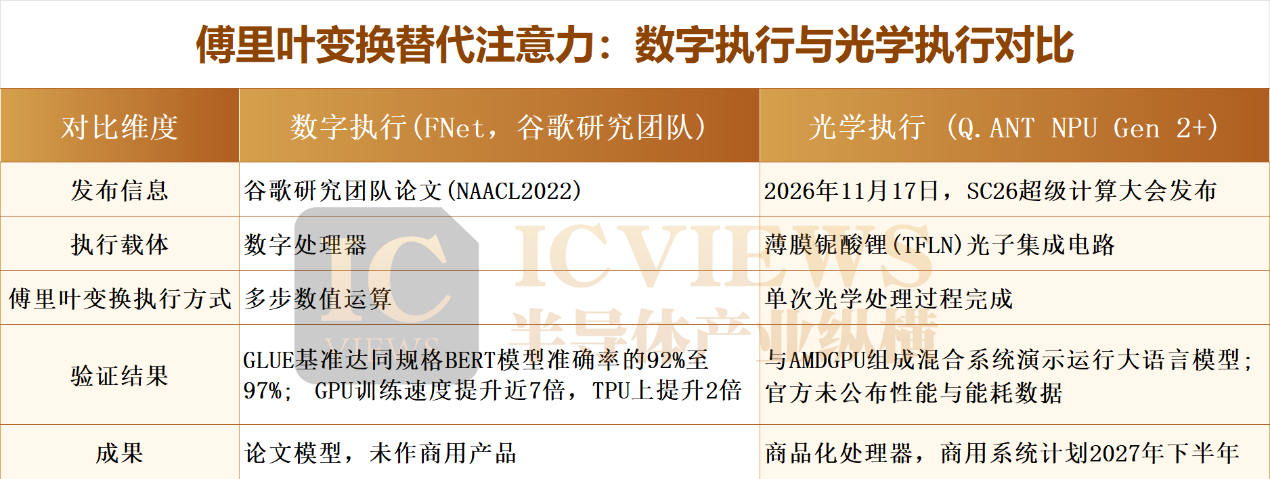
近日,德国光子计算企业Q.ANT在美国芝加哥举行的SC26超级计算大会上发布新一代光子处理器NPU Gen 2+,并现场演示了由这款处理器与AMD GPU组成的混合计算系统运行大语言模型。据Q.ANT官方消息,这是光子计算首次参与运行大语言模型。
NPU Gen 2+基于薄膜铌酸锂(TFLN)光子集成电路制造,新增光学离散傅里叶变换(DFT)能力,演示中用光学傅里叶运算替代了大语言模型中计算开销较高的一层注意力计算。该公司计划在2027年下半年推出同时集成NPU Gen 2与Gen 2+的商用系统。
傅里叶变换进光域,单次运算直出结果
离散傅里叶变换是把离散信号从时域转换到频域的基础运算,广泛用于信号处理、图像处理和数据分析。传统数字处理器通过多步数值运算实现这一变换,数据规模越大,开销越高。
NPU Gen 2+的核心,是光子芯片上一个专门执行离散傅里叶变换的光学器件,相关运算在单次光学处理过程中完成。据官方新闻稿,这把可用的运算扩展到经典计算的加法与乘法之外,为AI和高性能计算应用提供了新的算法设计空间。
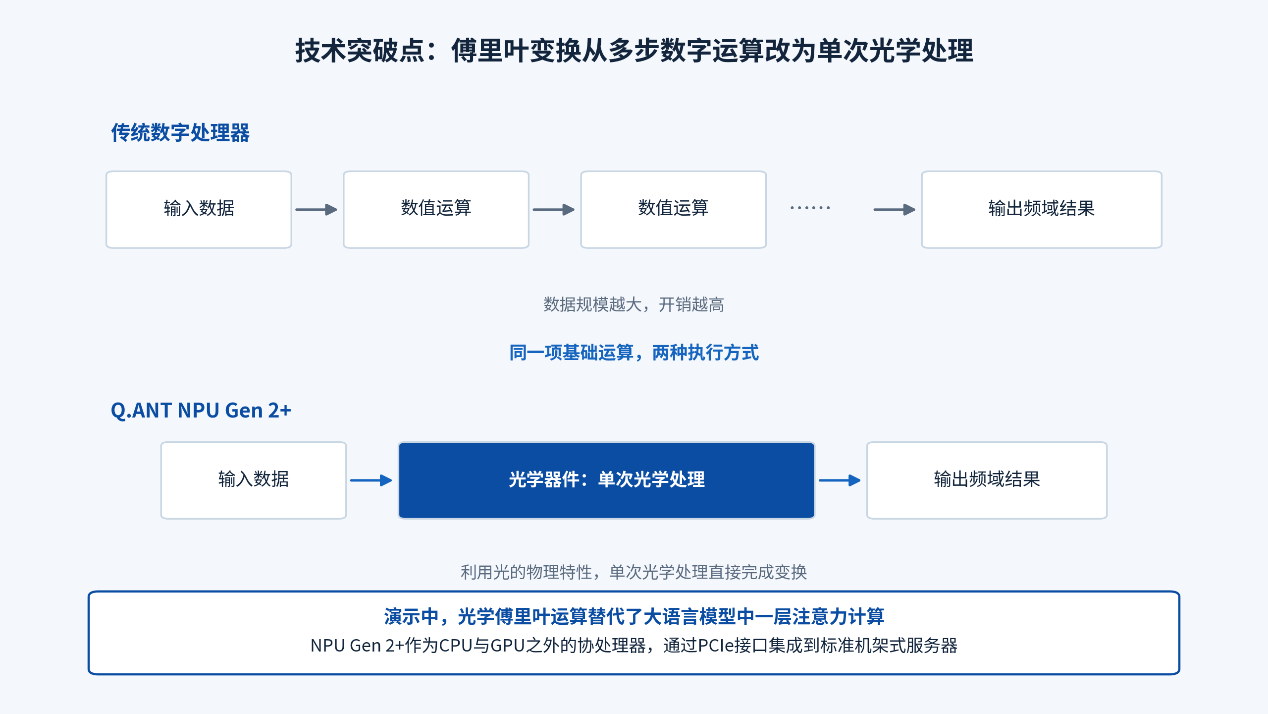
NPU Gen 2+延续了前代产品的定位,作为CPU和GPU之外的协处理器,通过PCIe接口集成到标准机架式服务器中。Q.ANT的思路,是把计算最密集的特定工作负载,分配到处理效率最高的硬件上执行。这款处理器基于NPU Gen 2迭代,后者于2025年发布,主要承担矩阵乘法和非线性运算。
光学替代注意力层,混合系统跑通大模型
主流大语言模型依靠注意力机制计算词元之间的关联,随着模型规模和序列长度增长,这部分计算会带来较高的算力与内存开销,是生成式AI的主要计算瓶颈之一。Q.ANT的演示针对的正是这一环节:混合系统运行大语言模型时,其中一层注意力计算改由光学傅里叶运算完成,用以缓解注意力机制带来的计算压力。
谷歌研究团队的FNet模型以无参数的傅里叶变换替代Transformer编码器中的自注意力子层,据其论文数据,在GLUE基准测试中达到同规格BERT模型准确率的92%至97%,在GPU上的训练速度提升近7倍,在TPU上提升2倍。FNet的傅里叶变换仍由数字处理器执行;Q.ANT的差异在于,把变换本身交给了光学器件。
Q.ANT首席执行官Michael Förtsch表示,随着Gen 2+的推出,我们为使用光的天然能力的软件打开了大门,这将带来参数更少、数据量更小的更精简的AI模型。通过在混合系统中与AMD GPU一同运行大语言模型,我们展示了这款处理器可以作为GPU的协处理器工作。
SDK开源降低门槛,试点预备商用
Q.ANT成立于2018年,总部位于德国斯图加特,运营着一条自有的TFLN芯片中试线。据官方信息,其系统已部署在多家科研计算中心,并通过云服务商IONOS提供商用部署。
在开发工具方面,Q.ANT在2026年9月开源了软件开发套件(SDK),提供C语言和Python接口、示例应用与文档,以及基于CPU的仿真环境。开发者无需实体光学硬件,即可在本地设计和测试光子计算应用。针对NPU Gen 2+,该公司正在扩展这套SDK,加入离散傅里叶变换功能,供开发者研究傅里叶算法在AI和高性能计算软件中的应用。
在硬件试用方面,Q.ANT与IONOS启动的光子计算试点项目,向获选用户开放德国数据中心的裸金属服务器,可远程访问真实的光子处理器,试点目前提供的是NPU Gen 2硬件。Q.ANT软件副总裁Utz Bacher表示:“光子计算让软件开发者有机会重新思考应用背后的数学逻辑。当复杂数学运算可以直接通过光的物理特性完成时,开发者能够提出的问题就发生了变化。”
Q.ANT还计划在单颗光子芯片上组合多种光学运算,以支持更复杂的计算流程。按照官方的表述,光子计算的规模优势,最终取决于算法适配、系统集成、计算精度以及端到端的性能和能耗表现。
光子计算的商业化,正在从单点演示走向完整的产品路径,芯片、软件工具、云上硬件试用和商用系统计划已经串成一条线。NPU Gen 2+把可用的光学运算从矩阵乘法扩展到傅里叶变换,光子处理器由此进入大语言模型的工作流程。
对数据中心的算力采购方来说,这类协处理器的实际价值,要等商用系统交付后的实测数据来验证。官方表示,将光子硬件集成到数据中心环境,有望显著降低能耗和运营成本,这一表述能否兑现,是这条技术路线后续的主要观察点。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序