
更快的HBM,能否破解AI的内存瓶颈?
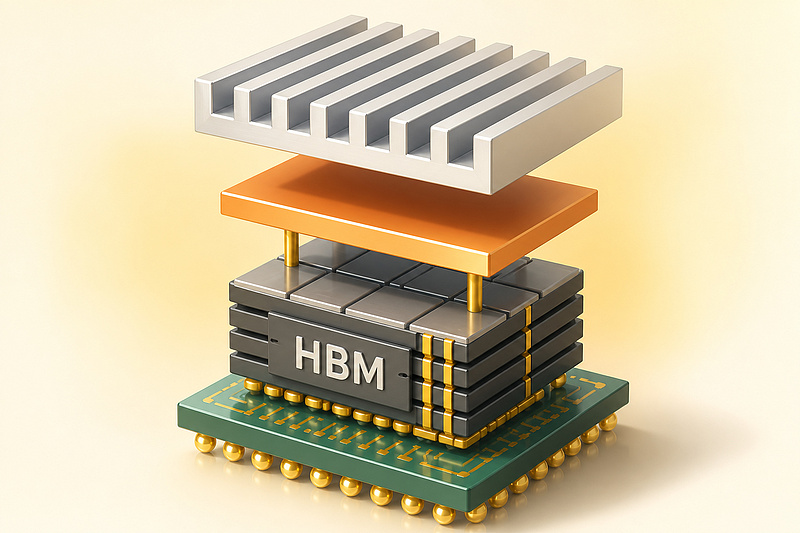
高带宽内存(HBM)正进入新一轮快速发展期。HBM4拓宽接口位宽、提升可用带宽,定制化HBM架构也为优化内存与AI加速器的连接方式创造条件。这些进展解决了现代AI计算的一大局限:处理器算力持续变强,但如果所需数据无法高效输送,就跑不出理论性能。
不过还有一个更本质的问题。即便HBM带宽持续提升,AI应用的运行速度会随之同比加快吗?未必。答案取决于内存系统里,究竟是哪一环制约着负载的运行。带宽、容量、延迟、数据复用率,以及加速器本地之外的跨设备通信,都会形成不同约束。
更快的HBM可以缓解一类瓶颈,却可能暴露出新的瓶颈。理解这一点,对AI加速器架构设计和先进半导体封装都愈发关键。
为什么HBM带宽至关重要
现代AI加速器会执行海量运算,而运算需要持续读取模型权重、激活值、注意力数据以及中间计算结果。HBM依托宽接口,以及紧贴处理器垂直堆叠的DRAM堆栈,实现高带宽。这种物理上的近距离,让加速器能够获得远超传统外部内存接口所能提供的内存带宽。
当一项任务需要搬运的数据量,相对于其上执行的计算量占比较高时,HBM带来的收益尤为突出。描述该关系的一个核心指标是算术强度。
公式(1)—— 算术强度
$$I=N_{operations}/V_{memory}$$
式中,$$N_{operations$$为运算次数;$$V_{memory$$为处理器与待评估内存层级之间传输的数据总量(字节)。
算术强度低的负载:每次运算需要搬运大量数据,性能容易受内存带宽限制。 算术强度高的负载:每传输一字节数据就能完成更多运算,性能更大概率受算力制约。
区分这两者,是判断提升HBM带宽能否创造价值的核心。
我们来看一款简化版加速器,它拥有峰值计算吞吐$$P_{\mathrm{peak}$$和可持续内存带宽$$B_{\mathrm{sustained}$$。
屋顶线模型给出了计算吞吐的性能上限。
公式(2)—— 屋顶线性能上限
$$P_{\mathrm{attainable}} \le \min(P_{\mathrm{peak}},\ B_{\mathrm{sustained}} \cdot I$$
式中,$$P_{\mathrm{peak}$$是峰值计算吞吐;$$B_{\mathrm{sustained}$$是可持续内存带宽;I是对应内存层级下的算术强度。
该公式量纲自洽:内存带宽(字节 / 秒) × 算术强度(运算 / 字节) = 运算 / 秒。这只是性能上限,不等于应用实际能跑出的吞吐。真实性能还取决于实现效率、内存访问模式、同步开销以及其他系统因素。
如果负载明显受带宽约束,拉高可持续带宽能够抬升性能上限。 可一旦负载逼近算力上限,继续增加带宽,收益就会快速递减。
这就是更快的HBM无法自动让AI系统提速的第一个原因。
AI训练与推理面临的内存难题并不相同
增加带宽带来的收益,随负载类型差异巨大。AI训练过程中,大型矩阵运算可以大量复用数据;尤其是调度方案充分发挥加速器资源效率的时候。一部分任务属于算力受限,另一部分则受内存流量、通信开销或是中间数据管理的限制。 因此训练性能,是计算吞吐、内存访问、多加速器通信三者之间的平衡结果。
推理场景则是另一套逻辑。预填充(Prefill)阶段处理输入词元,生成后续文本所需的全部信息。大规模并行矩阵运算可以实现很高的数据复用,往往属于算力受限。解码(Decode)阶段逐个生成后续词元,计算结构完全不同。 受模型架构、批大小、上下文长度、工程实现方案影响,解码阶段常常需要反复搬运模型权重或注意力数据,但单位数据对应的计算量偏少。
这类场景下,提升HBM带宽能够显著提高词元生成吞吐。 但这个收益并不是通用的。更大的批处理规模可以提升数据复用率与算术强度;长上下文注意力会产生巨大的KV缓存流量;投机解码等执行技术,同样会改变限制性能的资源瓶颈。
所以不存在一套统一的带宽需求,适配全部AI推理负载。工程层面要考虑的,不只是HBM接口能跑多快, 而是负载能不能高效利用新增出来的带宽。
容量困境:内存速度快,不代表内存容量够用
带宽决定数据传输快慢, 容量决定某一层内存最多可以存放多少数据。二者相关,但约束完全不一样。AI模型需要把权重、激活值、临时数据以及推理状态,全部安置在可用的内存层级里。 大语言模型推理场景中,KV缓存会大量占用HBM容量,上下文越长、并发请求越多,占用越明显。
如果工作集超出HBM可用容量,系统就需要把数据分发到更多加速器,或将部分数据转移至其他内存层级,或是调整请求调度与处理逻辑。这些操作会引入通信开销、额外延迟,降低计算效率。 而更快的HBM接口,并不能消除这些代价。
我们假设有两套加速器配置: 一套HBM带宽更高,但容量有限; 另一套带宽适度降低,但容量足够把整套工作集留在本地。当工作集都能装进两套方案的HBM时,第一套可以受益于更高带宽。 一旦工作集超出第一套的容量上限,第二套则可以规避代价高昂的数据迁出与分布式通信。 带宽更高的内存接口,反而可能属于整体速度更慢的系统。
这并不是说容量永远比带宽更重要。 而是内存性能,取决于工作集大小、带宽,以及数据在内存层级中的存放位置三者之间的相互关系。
破解内存瓶颈的四条路径
加速器设计者有多种方式提升有效内存性能, 每种方案解决问题的不同侧面。
方案A:提升HBM带宽 最直接的方式,就是提高单位时间的数据传输量。
加宽接口、提升信号速率、优化内存架构,都可以拉高总带宽。 适合性能被持续内存流量制约、且计算单元有能力消化新增数据流的应用。但带宽提升,往往需要配套更多接口资源、供电能力、布线资源以及热管理方案。 系统还要验证:在目标负载与环境工况下,带宽能够稳定跑满。
方案B:提升HBM容量 另一条思路是提高内存密度,或是为加速器搭配更多内存堆栈。
更大容量可以支撑更大模型、更长上下文、更多并发请求,降低对低速内存层级的依赖。但扩容也有成本。 新增堆栈会占用封装面积,带来布线、供电压力,增加热设计与制造的复杂度。 即便容量更大,如果负载本身受带宽或者算力限制,吞吐也不会自动提升。
方案C:降低内存流量 第三种思路,减少内存与计算单元之间必须搬运的数据量。
量化压缩、缓存机制、改进注意力算法、数据复用、面向负载的调度策略,都可以降低内存流量,或是提升每字节数据对应的有效计算量。这条路径价值很高:它是挖掘现有带宽的利用率,而不是单纯依靠物理接口提速。 代价可能涉及数值精度损失、额外计算开销、软件复杂度、缓存管理开销或是场景适配限制。目标是减少不必要的数据搬移,同时不牺牲应用所需的性能与精度。
方案D:重构内存层级架构 第四条路径:改变数据存放位置,以及数据在各个内存层级之间的流转方式。
片上SRAM、本地HBM、挂载在其他加速器上的内存、主机内存,分别提供不同的带宽、容量、延迟与成本组合。数据放置策略决定高频访问信息是紧贴计算单元,还是需要跨多层接口搬运。 当AI系统扩展到多加速器架构时,这一点变得尤为重要。针对某一类负载优化的内存层级,未必适配其他负载。最优架构取决于工作集、访问模式、通信需求,以及跨层搬移数据的成本。
以上四种方案并不互斥。 一套成熟的AI系统,往往需要同时提升带宽、扩容容量、优化数据复用、做好数据放置策略。
为什么HBM提速,只会转移瓶颈
假设某AI任务每完成一轮运算,需要搬运固定体量的数据。 在负载受带宽约束、且硬件能够利用新增带宽的前提下,提升可持续内存带宽可以缩短数据传输耗时。可一旦内存传输耗时低于另一项操作的耗时,继续优化带宽,就不再决定整体性能。举例:HBM访问延迟降下来之后,真正的约束可能转移到计算吞吐、同步开销、加速器间通信或是软件调度。 同理,本地内存带宽提升之后,远端数据搬移耗时在总耗时中的占比会被放大。
这是一条重要的架构推论: 优化内存系统里的某一环,会改变其余环节的相对重要程度。因此工程分析,必须在内存优化前后,识别出起主导作用的瓶颈。 只对比HBM标称峰值带宽,无法推导出应用层面的实际加速效果。 有效的评估指标包括:真实带宽利用率、执行耗时、词元吞吐、延迟、工作集驻留情况,以及典型负载下的系统功耗。
带宽提升带来的功耗与散热影响
更高带宽,也会提高内存子系统的物理压力。内存运行总功耗由多重因素决定,包括DRAM激活、接口收发、控制器逻辑、数据搬移、运行工况等。 一套带宽更高的架构,或许可以降低每比特传输的能耗,但在部分负载下,内存子系统总功耗依旧会上涨。所以带宽和功耗必须放在一起评估。 衡量能效,不能只看内存系统峰值传输速率,而要看在实际工况下传输有效数据所消耗的能量。
热效应会带来更多变数。 HBM堆栈由多颗垂直堆叠的内存裸片通过高密度互联结构相连。 产热与散热取决于堆栈结构、运行负载、邻近加速器功耗、材料特性以及整套封装架构。
高性能加速器会给旁边的内存带来严苛的热环境;内存高负载运行时自身也会发热。 如果热约束、功耗上限压低了可持续性能,实际可用带宽就会低于接口标称规格。
这就区分出两个概念:宣传标称带宽,以及产品额定工况下能够稳定维持的带宽。 对于先进封装工程师来说,内存架构问题,本质就是系统集成问题。
封装层面会发生哪些变化?
HBM性能提升,影响的不只是DRAM堆栈本身。加速器封装必须配套对应的电气接口、供电结构、散热通路与机械设计。总带宽提升之后,根据内存代际与架构选择,可能需要调整信号排布、布线资源、接口位置、互联密度。 这些约束会和中介层尺寸、基板工艺、封装外形、电源分配、热管理的物理上限互相牵制。
新增内存堆栈来扩容,则会带来另一组约束。 更多堆栈占用物理面积,还会改变信号布线、电源分配、装配流程、热交互以及测试方案。
内存配置选型,必须作为整套封装架构的一部分来评估。 一份纸面内存规格亮眼的设计,若带来过高的封装成本与约束,实际系统收益会大打折扣。 这点对于异构AI封装尤其关键:计算单元、内存、高速通信模块,会争夺有限的物理资源。
性能离不开制造与验证
下一大挑战是制造的一致性。标称的内存接口规格描述的是设计目标;但成品在流片、堆叠、组装、可靠性验证完成之后,依旧要满足指标。HBM制造依赖稳定的DRAM工艺、垂直互联成型、裸片对位、键合完整性、电性测试以及热可靠性。 内存堆栈的性能要求越高,工艺偏差就越容易影响电气裕量、热表现以及成品封装的工作特性。这不代表更高带宽一定会降低良率。 而是对应的制造工艺,必须具备匹配设计指标的能力。
工程师要区分内存架构的标称性能,和真实制造、产品验证能够支撑的性能。举例:两套方案标称带宽一致,但功耗、电气裕量、热表现可以完全不同。 当多组内存堆栈和高功耗加速器集成在一起,这些差异会变得非常关键。
工程难点在于:在控制制造成本的前提下,在全部工况区间,稳定实现所需的带宽、容量与可靠性。 这也是为什么评判HBM性能,不能只看接口速率。
行业下一步该往哪优化?
HBM下一阶段研发,应当聚焦有效内存性能,而不是单纯追逐峰值带宽。 当内存传输是负载的核心约束时,拉高带宽收益最大。一旦容量、延迟、算力或是互联通信成为瓶颈,其他架构改进能带来更大价值。合理思路是:让内存带宽、容量匹配负载需求,优化数据复用与数据放置;同时在功耗、散热、封装、制造约束下评估整套系统。工程目标不是单独把每一项内存参数做到极致,而是面向目标负载,拿到最优可持续AI性能。
工程总结
HBM已经成为现代AI基础设施的标志性技术,它让高性能处理器能够高速读取海量数据。 行业正走向更宽接口、更大容量、更多定制化内存架构,性能潜力依旧很大。但带宽仅仅是内存问题其中一个维度。 整套系统,需要在带宽、容量、延迟、算术强度、功耗、封装约束、制造能力之间做好权衡。
更快的HBM可以消除关键瓶颈,却无法保证不会冒出新的瓶颈。下一代AI加速器的核心竞争力,不只在于内存的数据传输速度,更在于整套系统高效利用数据的能力。
Moh黄金准则:只有当内存带宽就是系统瓶颈时,更快的内存才能提升AI性能。真正的工程目标,是在系统功耗、散热、制造的限制之内,在正确的位置、正确的时间,拿到正确的数据。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序