
一枚小磁体,让晶体管电路变身类脑神经元
研究人员设计出一种电子神经元,它结合了两种简单元件:一颗常规晶体管和一个纳米级磁器件,以此复刻生物神经元的行为。和传统电子神经元不同,这类神经元特性是由器件的磁属性自然产生的,无需复杂的控制电路。该电路能够生成时间精准的电脉冲,和生物神经元的脉冲信号相似,并且在一项小型验证实验中实现了机器学习。
当下最新一代人工智能有一个棘手的问题:模型规模越大,需要的芯片、数据搬运量以及耗电量就越高。因此,下一代人工智能硬件的目标不只是让计算机更智能,还要大幅降低计算过程中的能耗浪费。
密歇根州奥克兰大学的一支研究团队提出了一种减少这类能耗损耗的方案:用标准电子晶体管搭配磁隧道结(MTJ)来搭建人工神经元。在仿真实验中,由这些器件构成的网络依靠电尖峰脉冲的时序(而非传统数字信号)完成了经典机器学习基准任务 —— 异或门运算。这项研究近期发表于《IEEE电路与系统汇刊》。目前该研究还停留在仿真阶段,但它指明了一个可行方向:让人工智能硬件不再像传统计算机,而是更接近大脑的工作模式 —— 仅在有事件触发时激活,依靠材料自身的物理特性承担一部分计算工作。
“人脑运行功耗仅20瓦;而典型人工智能模型做推理时,能耗大约是人脑的500倍,每回答一个问题,能耗还要再增加50倍。” 奥克兰大学团队的首席研究员Steven Louis博士表示,“对于日常终端设备来说,这个功耗太高了。我们希望人工智能能够本地运行,不必依赖大型数据中心。模仿生物机理,或许是实现这一目标的途径。”
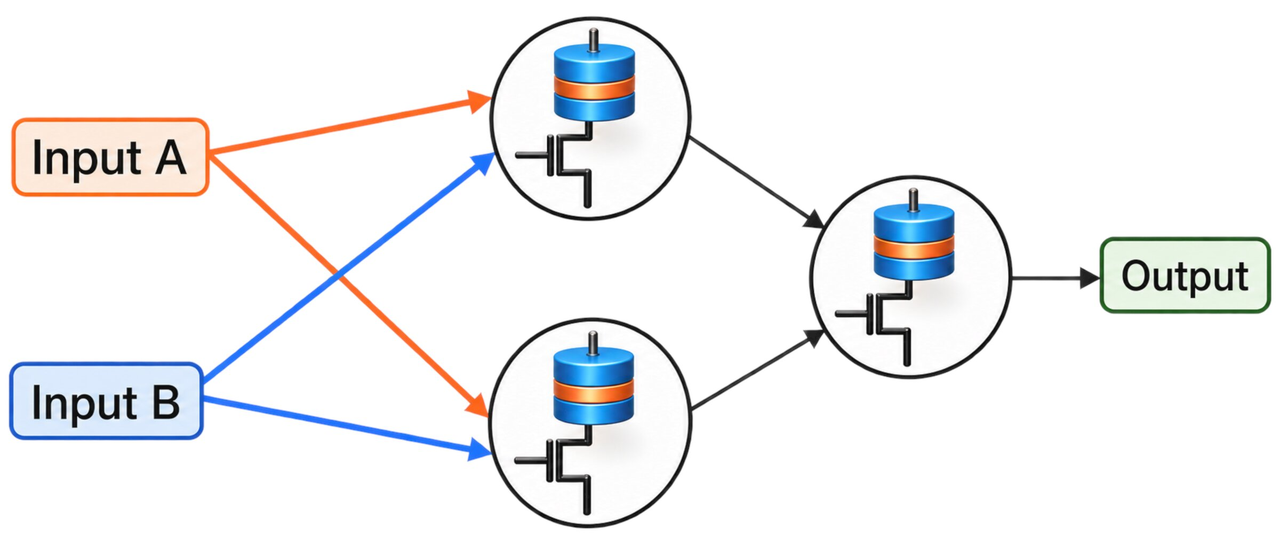
多个磁神经元协同工作。两路输入信号经过由突触连接的磁神经元网络。通过调整这些连接的强度,网络可以学习完成异或运算等任务。
依靠磁体辅助计算
磁隧道结(MTJ)已经在磁阻随机存储器(MRAM)中得到广泛应用。它包含多层磁性薄膜,薄膜之间由极薄的绝缘势垒隔开。当有电流流过器件时,其中一层磁性薄膜可以改变磁化方向。
原理在于电子具备一种名为自旋的属性,自旋的表现有点类似微型磁取向。电流流过磁隧道结时,电子自旋会对磁化状态施加微弱的扭转力矩,研究人员称之为自旋转移矩。
这种效应本身十分微弱,但在纳米尺度下,能够产生可测量的变化。磁化状态发生改变时,磁隧道结的电阻也随之改变。在存储芯片里,这种变化可以用来代表一个存储比特。而在本研究中,研究人员赋予了它新用途:用来生成生物神经元用于信息通信的短促电脉冲,也就是 “尖峰信号”。
磁隧道结搭配一颗NMOS晶体管 —— 也就是现代芯片里随处可见的基础通断开关。晶体管控制流经磁器件的电流。磁化状态改变,磁隧道结电阻跟着变化,进而改变电路电压。在合适条件下,电路就会产生尖峰脉冲。磁隧道结和晶体管组合在一起,就构成一个 “磁神经元”。
生物神经元不会对每一路输入信号都做出响应。它会汇总输入信号,只有信号总和超过阈值时才会触发脉冲,之后会进入一段短暂的不应期,等待恢复后才能再次触发。仿真磁神经元复刻了多种典型的神经元特性:阈值尖峰发放、信号延迟、不应期、突触信号整合以及抑制效应。
传统电子神经元想要复刻这些特性,往往需要由大量晶体管组成的复杂电路;而这套方案里,相关特性直接来自单个磁隧道结的磁动力学效应。
它并不是真正的生物神经元,但可以复刻神经元具备价值的计算行为。
为什么不直接使用普通芯片?
传统计算机的存储单元和计算单元大多相互分离。处理器读取数据、完成运算、写回结果,再继续执行下一步。现代人工智能加速器(包括GPU)已经把这套流程优化得非常高效,但数据在存储单元与计算单元之间搬运,依旧会消耗巨量电能。
神经形态硬件试图打破存储和计算的边界。一个物理器件既可以保存状态、存储信息,同时也参与计算。在本方案中,磁隧道结不断变化的磁化状态不只是电路的测量对象;它的动态特性直接决定神经元何时发放尖峰脉冲。
这一点对不需要持续运行的人工智能系统意义重大。尖峰脉冲电路在没有脉冲到来时基本处于休眠状态,不会针对未变化的数据反复执行高能耗运算。
因此该方案在功耗受限、事件驱动型场景具备潜力:工业传感器、机器人、摄像头、音频设备以及可穿戴设备。这类场景的数据大多是间歇性到达,而非持续不断的数据流。
由时序承载信息
这套设计的关键创新点:电路依靠尖峰脉冲出现的时间来编码信息。
传统数字系统中,信号一般解读为逻辑状态:1或者0。尖峰脉冲系统里,较早到达的脉冲和较晚到达的脉冲代表的含义并不相同,脉冲时序本身就是待处理信息的一部分。
在奥克兰大学的仿真实验中,人工神经元依靠纳秒级别的尖峰时序完成信息交互。研究人员测得神经元典型响应延迟低于5纳秒;网络的工作模式为:每组输入信号最多让单个神经元产生一次尖峰脉冲。
时序不只是输出结果,更是学习的基础。
简易学习测试
为验证这类神经元不只是能够发放脉冲,研究人员把它们搭建为小型多层网络,并用异或门任务开展训练 —— 异或门是非线性机器学习的经典基准测试。
网络初始的突触权重无法输出正确结果。训练过程中,网络反复执行推理,对比实际输出的尖峰时序和目标时序,并基于梯度下降规则调整突触权重。训练完成后,网络可以实现异或运算。
研究人员表示,在仿真条件下该网络能够收敛,整套非线性处理、多层信号交互和权重自适应过程,全部在模拟电路内完成。甚至训练过程本身也在仿真模拟电路内部执行,不是依靠外部软件实现。
这只是一个规模很小的验证,没有人认为少量磁神经元可以取代GPU。但更值得关注的一点是:磁器件的物理动态特性直接参与计算,而不只是单纯存储数据,交由传统处理器运算。
务实的技术路线
奥克兰大学团队将这套方案描述为 “CMOS+X”。简单来说,它没有抛弃当前芯片制造所用的成熟工艺,而是在传统电子器件之外新增一类器件,也就是自旋电子器件。
这让该构想不像第一眼看上去那么遥不可及。得益于在MRAM和传感器中的应用,磁隧道结以及同类磁器件已经拥有成熟的制造体系和研究基础。目前尚存的疑问是:这类器件能否同时成为实用的计算单元。
局限:器件尚未实物制备
尽管已发表的结果前景可观,到目前为止相关结论仅通过LTspice电路仿真验证。制备出这种神经元器件并在实验室完成实测,还需要时间和资金投入。
后续研究十分关键,因为真实磁器件的特性并不理想。工艺偏差会改变器件行为,热扰动会干扰磁化状态,温度差异、电阻偏差以及自发热效应,都可能影响尖峰脉冲生成的稳定性。因此下一步核心工作,就是确认在真实工况下,尖峰时序能够保持多高的稳定性。
仿真系统的部分模块也做了理想化处理,部分突触和学习电路采用功能模型搭建,并没有做到完整的晶体管级实现。
磁体只是起点
一款可用的神经形态处理器,远不止需要单个能工作的人工神经元。后续研究阶段需要把大量器件互联、开发可用突触、解决器件之间的性能偏差,同时设计对应的训练算法,避免这套系统最终变回传统数字计算机。
即便如此,该架构简洁的特点很有吸引力:晶体管控制磁器件,磁体改变自身状态,进而改变电信号,电路生成携带时序信息的尖峰脉冲。
“把足够多这类单元组合在一起,整体就不再像传统处理器,而更像一堆生物神经元。”Louis说道。至于这套架构能否带来速度更快、能效更高的人工智能,还有待验证。但他的研究提供了一种新思路:未来人工智能硬件,或许不需要显式计算神经网络里的每一项数值。一部分计算工作,可以依靠材料自身的物理特性自然完成。
而在这个方案里,承担这项工作的,就是一枚微型磁体。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序