
CPO万卡集群落地,光互连迈向规模化应用
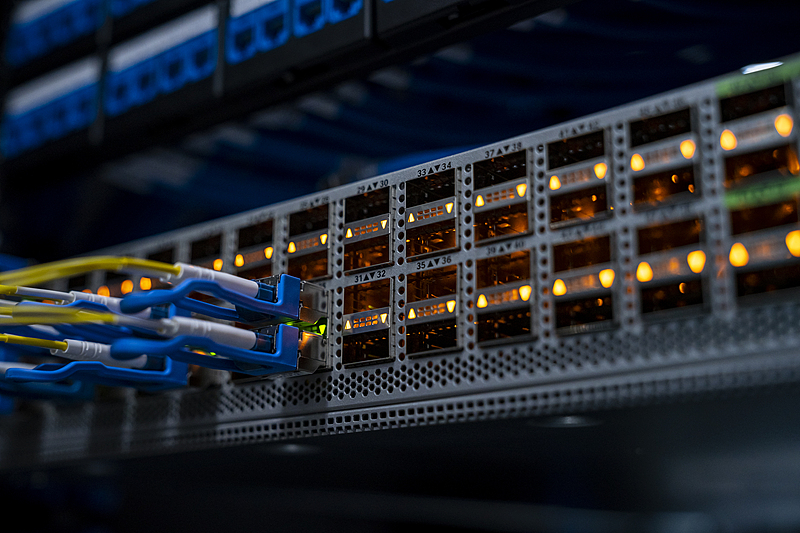
AI数据中心的规模不断扩大,GPU之间的数据交换也成为影响集群运行效率的重要因素。当数千乃至上万颗GPU共同参与模型训练时,网络需要承担大量数据传输任务。交换机、光模块和互连架构的性能,都会影响整个集群的运行效率。
近日,AI云服务提供商Lambda宣布,已经在加拿大魁北克园区部署英伟达Photonics共封装光学(CPO)交换机,实现对超过1万颗英伟达Blackwell Ultra GPU的网络连接。Lambda称,这是全球首个大规模CPO网络部署项目,并公布了相关测试结果。与传统可插拔光学方案相比,新方案在保持相同吞吐量的情况下,将Pod级网络延迟最多降低10.1%。
此次部署也意味着CPO技术开始进入更大规模的AI数据中心网络环境。对于需要大量GPU协同工作的集群来说,网络架构的调整有望进一步改善数据传输效率。
CPO改变光电转换位置,缩短信号传输路径
要理解此次部署的意义,需要先了解CPO与传统可插拔光模块的区别。
在传统网络交换机中,电信号需要从交换芯片出发,经过电路板走线和连接器,最终到达安装在交换机前面板上的光模块,再由光模块完成电信号与光信号之间的转换。随着数据传输速率提高,这段电信号传输路径会带来信号损耗,同时也需要额外的信号处理和补偿电路。
CPO改变了这一结构。它将光引擎放置在交换芯片ASIC旁边,并集成在同一封装中,使电信号能够在更短的距离内完成光电转换。按照英伟达的介绍,传统方案中长达数英寸的电信号传输路径,可以缩短至数毫米,同时减少信号损耗,并省去部分重定时器(Retimer)芯片。
这一调整带来的影响主要体现在三个方面。
首先是信号质量。电信号传输距离缩短,可以降低传输过程中的损耗,改善高速信号的完整性。
其次是功耗。传统可插拔光模块需要承担较长电信号路径上的信号处理工作,相关电路也会消耗额外电力。CPO减少中间连接和信号处理环节,有助于降低网络设备的能耗。
最后是可靠性。传统方案中,光模块包含多个独立器件和连接环节,任何一个部件出现故障,都可能影响链路运行。CPO通过减少部分独立器件和连接点,降低潜在故障来源。
1万颗GPU集群测试,Pod级延迟降低约10%
此次Lambda部署的英伟达Photonics交换机采用了较高密度的光互连配置。每台交换机配备144个800Gb/s端口,同时采用液冷设计,并设置18个可拆卸外置光源模块,为交换机内部的光引擎提供光源。
值得关注的是,Lambda此次还将CPO方案与传统可插拔光学方案进行了对比测试,测试范围覆盖机架(Rack)、可扩展单元(Scalable Unit)和Pod三个层级。
测试结果显示,两种方案的网络吞吐量保持一致,但CPO在三个层级均取得了更低的网络延迟。其中,机架级延迟降低3.8%,Pod级延迟降幅最高达到10.1%。
这一结果与集群规模扩大后的网络通信特点有关。单个机架内部的GPU可以通过本地网络完成数据交换,而当计算任务扩展至多个机架时,数据需要经过更复杂的交换网络。不同机架之间的数据传输涉及更多网络设备和连接链路,延迟也更容易累积。
因此,相比单一机架内部的测试,Pod级测试更能反映CPO在多机架协同计算环境中的表现。
温度方面,Lambda公布的测试数据显示,CPO光学器件的运行中位温度为36℃,传统可插拔光学方案则为51℃,两者相差15℃。
英伟达网络业务高级副总裁Gilad Shainer表示,Photonics技术能够降低网络功耗、提高系统韧性,并实现最高15倍的可靠性提升,让客户从GPU投资中获得更多有效运行时间。
可更换光源,兼顾设备维护
CPO虽然将光引擎集成到交换芯片封装附近,但并不意味着所有光学组件都无法更换。
此次使用的英伟达Photonics交换机保留了18个可拆卸外置光源模块。光源负责向光引擎提供光信号,光引擎则负责完成电信号与光信号的转换。两者采用不同的部署方式,使设备能够在保留CPO短距离信号传输优势的同时,维持一定的现场维护能力。
英伟达表示,如果传统可插拔光模块内部的激光器发生故障,通常需要更换整个模块。而在这一CPO设计中,技术人员可以单独更换外置光源模块,无需更换整个光引擎所在的封装部分。
对于拥有大量交换设备的AI数据中心来说,维护方式也会影响长期运营成本。减少故障点、降低设备温度,并将部分易损部件设计为可更换模块,有助于降低维护工作的复杂程度。
英伟达此前公布的技术资料还显示,其CPO方案相较传统可插拔光学方案,光学部分的功耗效率最高可提升5倍,可靠性最高可提升15倍。不过,这些属于英伟达公布的技术指标,不能直接等同于Lambda此次园区的实测节电比例。
AI集群扩张,网络能耗也需要精细化管理
GPU数量增加后,计算设备本身的功耗已经相当可观,网络设备也在占用越来越多的数据中心电力资源。对于大规模AI集群而言,交换机和光互连系统的数量会随计算规模增加,网络能耗逐渐成为数据中心建设和运营中需要考虑的部分。
Lambda此次部署所在的魁北克园区,已获得142MW的电力容量,能源供应近100%来自可再生能源。园区每年最多80%的时间可以利用自然冷却,并保证电力使用效率指标PUE达到1.2,同时服务器冷却不消耗工艺用水。
PUE是数据中心总能耗与IT设备能耗的比值,数值越接近1,说明用于制冷、供配电等辅助设施的能耗占比越低。
从此次部署来看,Lambda选择在超过1万颗GPU的集群中引入CPO,既关注网络延迟,也涉及交换设备的功耗、温度和维护问题。随着AI训练集群向更大规模扩展,光互连技术在网络架构中的重要性也将进一步提升。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序