
单颗GPU超5万CUDA核心,英伟达推出Rubin HPC
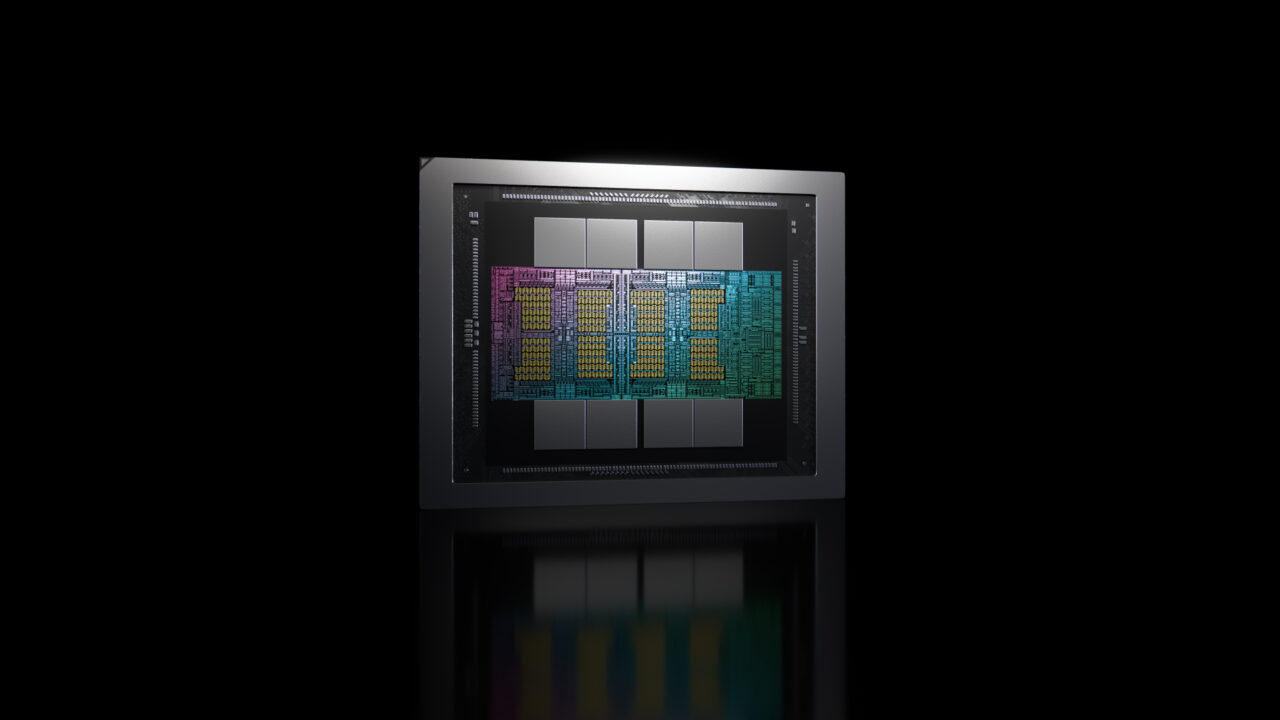
近日,在SC26超算大会上,英伟达宣布推出Rubin HPC。这是英伟达Vera Rubin平台中的一款全新GPU,主要面向科学、工程和数据分析工作负载,旨在加速相关领域的仿真计算与数据处理。
随着AI智能体逐渐参与科研和工程工作,科学家与工程师能够探索更多候选材料、分子以及设计方案。而这些想法能否成立,需要通过仿真进行测试,并根据模拟结果确定下一步研究方向。Rubin HPC将重点加速这一过程,帮助研究人员缩短从方案探索到科学发现和工业设计的时间。
在硬件配置方面,Rubin HPC单颗GPU搭载超过5万个CUDA核心,创下英伟达GPU核心数量的新纪录。同时,该GPU还引入了稀疏数据加速能力,能够持续为大量CUDA核心提供数据支持,并采用第七代英伟达NVLink互连技术,加快GPU与GPU之间的连接和数据传输。
在科学研究和工程设计中,仿真计算是理解复杂系统的重要手段。科学家和工程师通常需要先通过计算机模拟评估某种材料、分子或设计方案,再决定是否投入实际实验或制造实体原型。
AI智能体的加入,让研究人员能够同时探索更多候选材料、分子和设计方案,也使仿真计算的需求进一步增加。更多候选方案意味着需要运行更多GPU加速模拟,以评估不同想法的可行性,并为后续研究提供依据。
英伟达超大规模计算与高性能计算副总裁Ian Buck表示:“对于从事科学和工程工作的智能体来说,更快的仿真意味着更快的发现。Rubin HPC能够加速智能体用于测试想法、指导下一步工作的仿真过程,帮助科学家和工程师探索更多可能性,让突破性成果离我们更近。”
加快计算,推动科学发现
在气候模型、工程仿真、基因组分析和金融风险评估等领域,科学计算工作负载具有相似的数据处理特点:应用程序需要从庞大的数据集中读取少量分散的数据,完成计算并得出结果,然后在极大规模的数据集上不断重复这一过程。
面对这一挑战,Rubin HPC采用了平衡式设计,将数据移动能力与计算能力同步扩展,而非单纯增加计算资源。
这种设计也是Rubin HPC面向科学计算进行优化的关键。英伟达希望通过提高数据传输效率,让GPU中数量庞大的CUDA核心持续获得所需数据,使它们能够将更多时间用于实际计算,而不是等待数据到达。
Rubin HPC能够加速各类仿真工作负载中反复出现的计算模式,包括稀疏矩阵运算、模板计算、排序和归约操作。
这些计算模式广泛存在于数据分析、科学研究和工程工作负载中。因此,一款针对这些任务进行专门优化、能够提供广泛加速能力的GPU,有望帮助不同行业实现新的突破。
这些计算操作在不同应用中承担着不同任务。稀疏矩阵运算主要处理包含大量零值的矩阵数据。模板计算通常用于网格化数据处理,通过对某个数据点及其周围邻域进行重复计算,完成模拟过程。排序和归约则分别用于数据排列以及汇总计算结果。这些操作在科学模拟和数据分析中十分常见,对数据读取、传输和计算效率都有较高要求。
除了GPU本身的硬件升级,英伟达还强调了CUDA-X软件库在其中发挥的作用。
CUDA-X库提供了不断扩展的复杂算法优化实现,供AI智能体调用,其中也包括与仿真和数据分析密切相关的算法。与Rubin HPC结合使用后,这些软件库能够为智能体提供更高效的计算支持,帮助其更快完成推理并获得结果。
与此同时,Rubin HPC采用第七代英伟达NVLink互连技术,加速GPU之间的连接。对于需要大规模计算资源协同工作的科学研究任务而言,GPU之间的数据传输同样是影响整体计算效率的重要环节。
通过GPU硬件、NVLink互连技术和CUDA-X软件库的配合,英伟达希望让智能体能够更加高效地调用仿真和分析算法,进一步缩短从提出假设到获得计算结果的时间。
从整体工作流程来看,这套方案主要针对智能体参与科研后的计算需求变化。智能体提出研究假设或生成候选设计,随后调用仿真程序进行评估,再根据计算结果调整方案并开展新一轮模拟。这个过程会反复进行,对计算平台的数据处理能力和持续运行效率提出了更高要求。
英伟达表示,更快的智能体调用仿真意味着更快的反馈,能够缩短假设、仿真和方案优化之间的循环。研究人员和工程师可以更早获得模拟结果,及时决定后续研究方向,并将实验室资源集中投入到最有希望的候选方案上。
目前,Rubin HPC预计将于2028年推出。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序