
世界首颗!100纳秒解完矩阵方程
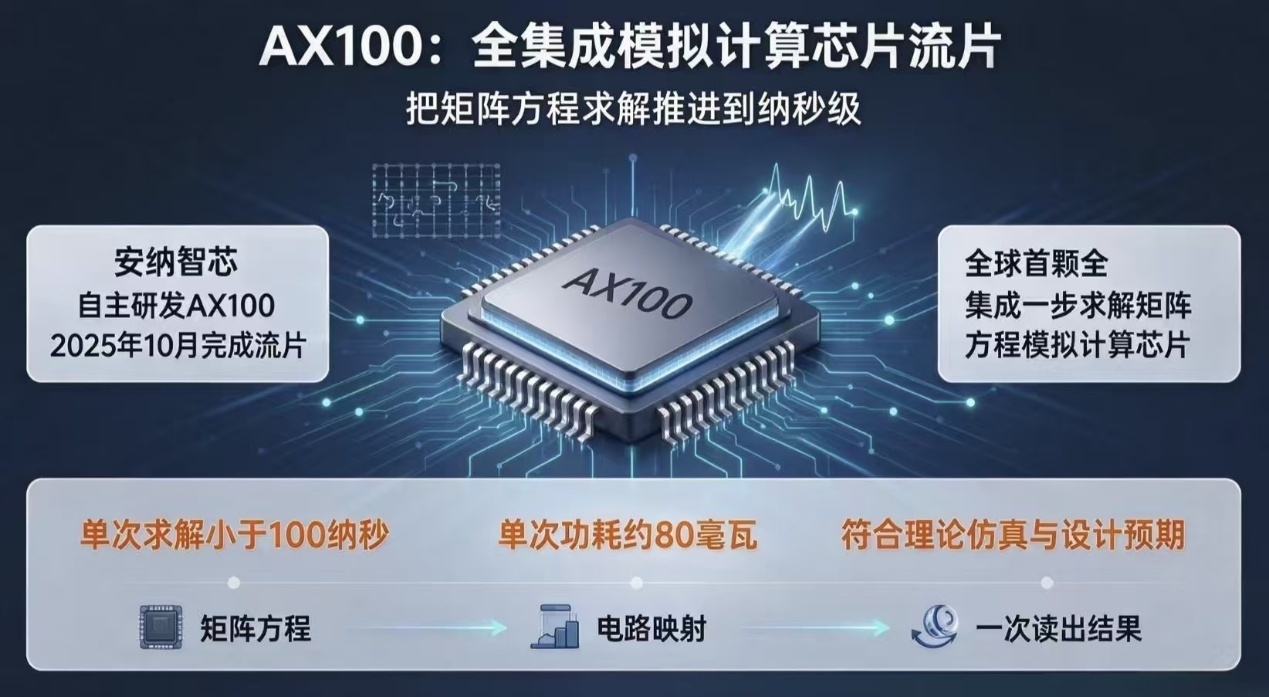
近日,模拟计算芯片公司安纳智芯宣布,其自主研发的AX100芯片已于10月完成流片,官方称这是世界首颗全集成一步求解矩阵方程模拟计算芯片。
经测试,单次矩阵方程求解时间小于100纳秒,单次计算功耗约80毫瓦,符合理论仿真与设计预期。芯片采用成熟工艺制造,不依赖先进制程,技术源头为北京大学人工智能研究院研究员孙仲团队2025年10月发表于《自然·电子学》的模拟计算精度提升成果。
映射矩阵方程,电路直出结果
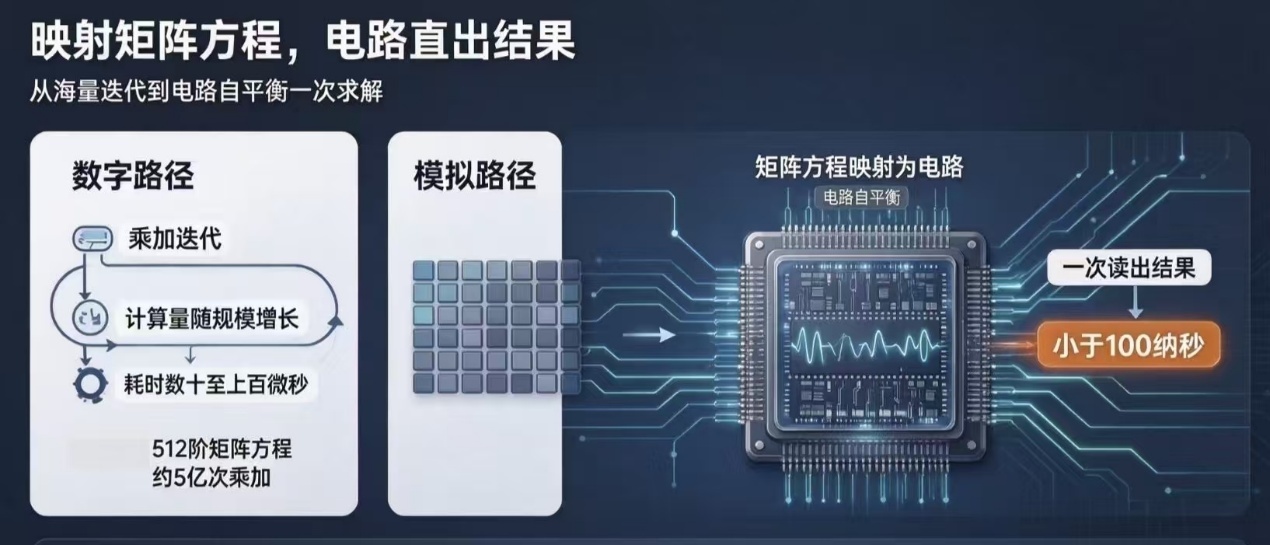
AI大模型训练中的参数优化、机器人的运动控制与空间规划、通信基站的信号处理,底层运算都可以归结为矩阵方程求解。数字芯片的做法是把“求解”拆解成海量乘加迭代,计算量随矩阵规模呈立方级增长。以512阶矩阵方程为例,约需5亿次乘加,耗时数十至上百微秒。
模拟计算走的是另一条路径。矩阵方程被直接映射为电路,电路自平衡后一次读出结果,中间没有迭代过程。安纳智芯CEO向锐将这一机制概括为:矩阵方程被直接映射为电路,电路自平衡后一次读出结果,无需迭代。
这条路径的工程难点长期集中在精度和可扩展性上。孙仲团队2025年10月的工作将模拟计算精度从此前的百分之一量级提升到千万分之一量级,单次矩阵方程求解相较于先进GPU运算速度快3个数量级、能耗比高2个数量级,为模拟计算从实验环境走向芯片产品提供了精度前提。
AX100的流片节点,验证的正是这条路径在产线上的可行性。从论文发表到芯片完成流片,间隔约一年,借助国内成熟的芯片制造封装产业链,模拟计算正式跨入了工程样品阶段。
落地三类负载,实测效能提速
新架构的工程价值需要真实负载来验证。在近期的公开测试中,AX100在三个典型场景下给出的实测数据指向同一类问题:矩阵方程求解环节的耗时和功耗,在系统整体预算中占了多大比重,模拟计算能把它压缩到什么程度。
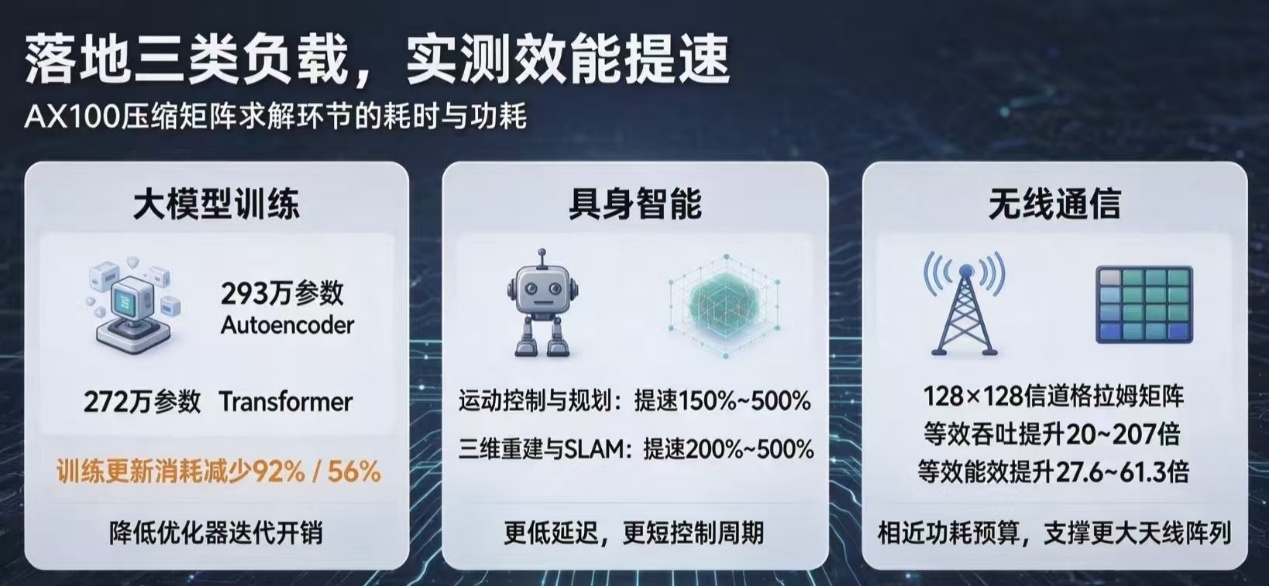
大模型训练方面,团队在293万参数的Autoencoder模型和272万参数的Transformer模型上开展验证。二阶优化方案使两类模型的训练更新消耗分别减少92%和56%。训练过程中的优化器更新涉及大量矩阵运算,模拟计算直接降低了这一环节的迭代开销。
具身智能方面的收益体现在实时性上。运动控制与规划端到端算法提速150%到500%,三维重建与SLAM核心算法环节提速200%到500%。机器人从感知到执行的闭环中,矩阵求解延迟的降低直接转化为控制周期的缩短。
无线通信场景的对比对象是现有数字ASIC与GPU。对于128×128规模的信道格拉姆矩阵,AX100的等效吞吐提升20至207倍,等效能效提升27.6至61.3倍。信道格拉姆矩阵是MIMO信号处理中的核心运算,吞吐和能效的同步提升意味着基站侧可以在相近的功耗预算下处理更大规模的天线阵列数据。
立足成熟产线,实现自主可控
长期以来,数字芯片的性能提升高度依赖制程微缩,先进制程节点,往往伴随着高昂的流片成本和产能紧张问题。AX100的制造路线避开了这条路径:芯片采用当前成熟工艺即可实现,全链路自主可控,不依赖先进制程。
这一选择与模拟计算的技术特征直接相关。模拟电路利用物理定律完成并行运算,性能上限更多取决于电路架构和器件匹配精度,而非晶体管密度的线性提升。当数字芯片在先进制程上追逐每瓦性能时,模拟计算在成熟节点上争取的是另一类指标:单次运算的绝对延迟和绝对功耗。对模拟计算而言,成熟工艺已经能够满足其运算需求,无需依赖昂贵的先进制程。
孙仲团队的精度提升成果解决了模拟计算长期被诟病的可靠性短板,安纳智芯的工程化能力则把这一成果带到了产线上。AX100和GPU类数字芯片在架构和底层逻辑上完全不同,具备现代模拟计算顶尖计算能力,这是中国企业第一次有机会参与定义一种重要计算范式。
AX100把模拟计算从“长期被忽略的领域”推到了“有产品可测”的阶段。矩阵方程求解是AI训练、机器人控制和通信信号处理的共同底层需求,当数字芯片的迭代路径越来越受先进制程和功耗堆叠约束时,模拟计算提供了架构层面的另一套方案。
从一颗完成流片的芯片,到规模化商用部署,中间还要跨过封装测试、软件工具链开发、客户导入、良率爬坡等一系列工程关卡。接下来的看点,在于安纳智芯能否围绕 AX100 补齐配套软件工具链,以及它在机器人、通信等真实系统中能发挥出多少实际工程价值。这也将决定这条技术路线,能否从单次流片,持续迭代成可商业化的产品序列。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序