
超越带宽,AI推理正在重塑内存墙
过去几年,AI基础设施一直在算力竞赛中狂奔。更多加速器、规模更大的异构集群、更高的峰值性能,支撑起能力越来越强的大模型。随着AI进入大规模落地阶段,基础设施需要承载更多用户、更大规模模型、更长上下文窗口,以及更复杂的应用。性能依旧重要,但延迟、功耗、资源利用率、可预测性以及单轮推理成本,同样不可忽视。
挑战已经不只是带宽问题。AI系统需要在内存容量、带宽、延迟、功耗、数据搬运、利用率和成本之间做平衡。优化其中一项指标,往往会给其他环节带来压力。键值缓存(KV缓存)就是典型的取舍案例:KV缓存能够减少生成式AI推理过程中的重复计算,但要求系统持续保存、反复读取不断膨胀的数据。上下文越长、并发请求越多,这种取舍矛盾就越突出。
这已经不只是又一个内存瓶颈,而是算力、内存、互联与软件之间的协同难题。只有系统能够合理放置、搬运、调取数据,同时不会让延迟、拥塞、功耗或是复杂度抵消收益,扩容或者提升带宽才有意义。
内存墙的边界正在拓宽
内存墙这个概念早于AI出现。长期以来,处理器性能的提升速度,一直快于内存系统向处理器供给数据的速度,而AI进一步放大了这个矛盾。如果加速器大量时间都在等待数据,再高的算术吞吐能力也很难发挥价值。
但带宽只是约束条件之一。AI系统还需要足够的内存容量,用来存放模型、中间数据、应用上下文以及推理状态;延迟决定响应速度;功耗约束着数据搬运的成本上限;封装方案与物理互联,限制了高性能内存贴近算力单元的部署规模。
这些需求经常互相冲突。紧贴加速器的高带宽内存可以提供极高带宽,但容量、功耗、成本都受到限制;大容量内存性价比更高,却达不到同等的带宽与延迟;在多层内存之间迁移数据,可以等效扩充可用容量,但会消耗带宽、电力与时间。
因此,内存墙正在演变为一个多维度的系统约束。
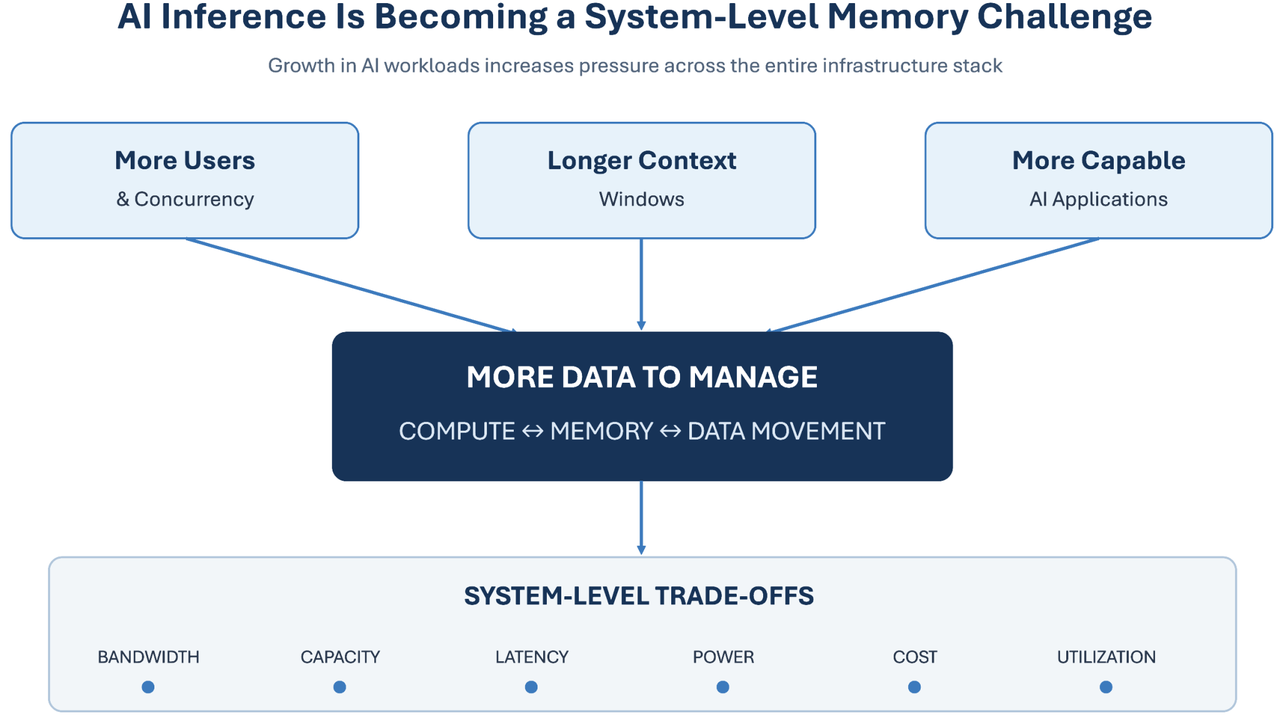
图1:AI规模扩张,让内存墙变成带宽、容量、延迟、功耗、成本、利用率之间的系统性权衡。
一套系统的总内存容量或许很大,但不是所有容量都能同等投入使用。下层存储里的数据虽然理论上可读,但距离太远、链路拥塞或是迁移成本过高,无法满足应用的服务等级目标(SLO)。
实际可用上限,不等于硬件标称容量,而是在业务允许的延迟、带宽、功耗范围内,能够真正用上的容量。
推理改变了成本逻辑
训练大模型需要海量算力与内存带宽,但本质上是构建、迭代模型的过程。推理则是持续、动态的任务:每一条提示词、每一个生成token、每一次智能体动作、每一回应用交互,都会持续消耗基础设施资源。
推理工作负载也不是单一类型:对话助手优先看重延迟;企业AI助手要处理大量私有上下文,同时服务大量用户;AI智能体需要在多轮交互中留存状态;面向C端的服务更看重吞吐与每token成本;批量推理则优先追求硬件利用率。
不同场景,对带宽、容量、延迟、功耗、成本的平衡点完全不同,架构设计必须适配业务负载。
KV缓存直观体现取舍关系
Transformer推理时,注意力机制会为序列里的每个token生成键(Key)、值(Value)表征。保留这些表征,后续解码步骤就可以复用历史状态,不用重复计算前面的token,以此提升推理效率;代价是减少重复计算的同时,加大了内存容量与数据搬运的压力。
更长的上下文窗口,会拉高单条序列的KV缓存占用;并发请求提升,会成倍放大这个需求。这项原本用来降低算力消耗的优化方案,反而产生了更多需要保存、读取的数据。
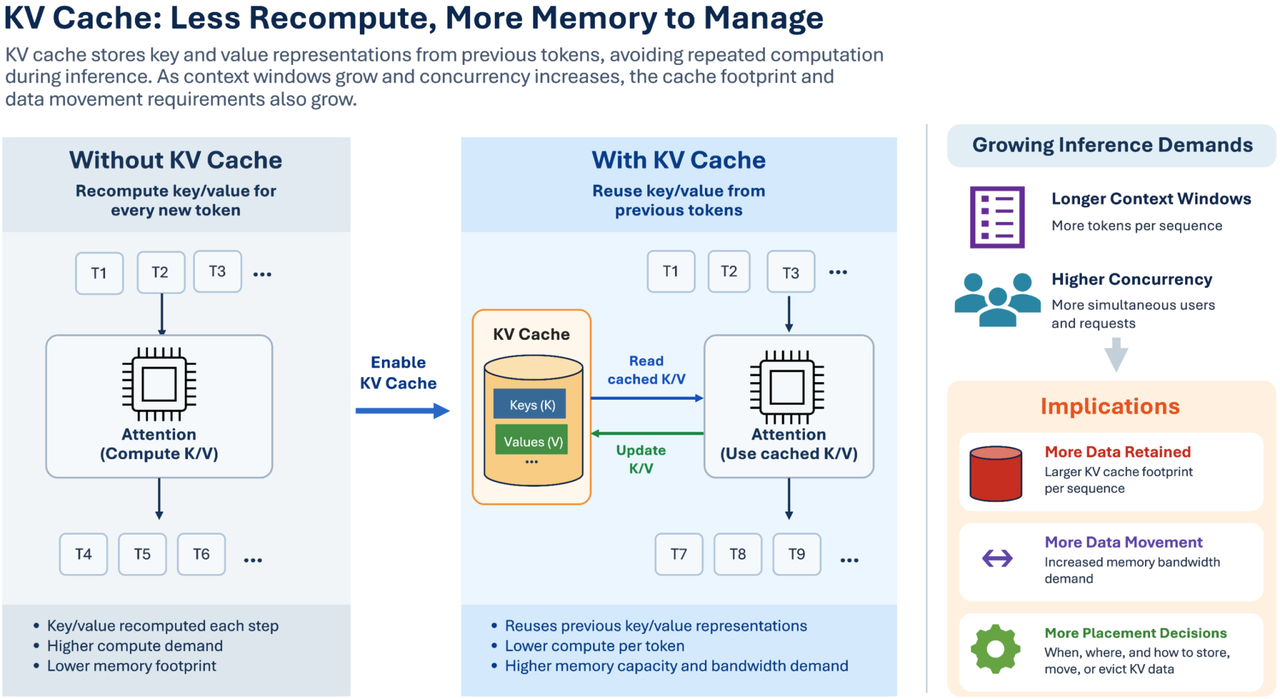
图2:减少重复计算可以提升效率,但更长上下文、更高并发,会增加需要保存、搬运、管理的数据量。
KV缓存状态还有完整生命周期:在预填充阶段生成,解码阶段反复读取,还可以保留下来复用。根据服务架构,KV状态可能被迁移、复制、压缩或者淘汰。每个阶段,对带宽、容量、延迟、控制逻辑的需求都不一样。
所以KV缓存不只是内存分配问题,更是数据生命周期管理问题。只有当释放的上层内存空间、或是规避掉的重复计算收益,超过数据迁移带来的延迟、带宽、能耗以及SLO不达标的风险时,把KV状态下沉到低成本存储层才有价值。简单来说:每一次数据迁移,都要收益大于成本。
负载决定架构形态
对延迟敏感的对话助手,适合把高频访问数据放在靠近加速器的位置;长上下文企业应用,优先保障容量;AI智能体需要更长生命周期的状态、更频繁的复用;大规模C端推理,重点优化吞吐、利用率与单token成本。
高频访问的数据,值得放在算力就近位置;其他数据可以接受更高延迟,换取更大容量或者更低成本,也可以随着访问模式变化,在多层存储之间迁移。目标不是消除内存分层,而是高效调度这套分层体系。
不存在单一的内存指标
带宽依然关键,但只盯着带宽优化,会忽略其他约束。容量决定可以常驻内存的模型与推理状态;延迟影响响应速度;功耗决定持续数据搬运是否可行;利用率衡量昂贵算力是在干活,还是在等待数据。
很高的总吞吐,有可能掩盖首token延迟、token间延迟或是拥塞场景下的尾延迟。更有参考价值的指标,是在满足延迟指标前提下,每瓦、每美元可以产出多少token。只看纸面带宽,解决不了内存墙问题。
真正要回答的问题是:怎样组合算力、内存、互联与软件,才能在给定功耗和成本预算内,提供稳定可预期的性能?
单纯增加内存远远不够
高带宽内存可以紧贴加速器快速供给数据;大容量存储层,可以在容量优先的场景下作为补充;内存扩容、内存池化,可以突破加速器本地内存的上限;软件层面,则根据业务需求完成KV状态的放置、复用、压缩、迁移、淘汰。
但每新增一层存储,都会带来更多调度决策。一套好用的架构,必须回答四个问题:
放置:哪些数据必须贴近算力,哪些数据可以放到更远的存储层?
迁移:什么时候迁移数据,比重算一遍更划算?
协同:加速器、内存控制器、互联、软件如何配合完成数据放置与迁移,避免拥塞?
保障:推理状态跨存储层调度时,系统如何保障可靠性、隔离性、数据完整性与性能可预测?
把数据迁移到大容量存储层,可以等效扩容,但会增加延迟;复制状态可以规避重算,却会消耗别处的带宽与容量;内存池化能够提升利用率,前提是竞争冲突与服务质量可控。优势不是来自把某一项内存参数拉满,或是单纯多加一层存储,而是把分层存储当成一套系统协同调度。
内存墙会持续演变
更高带宽内存、更大容量、更快互联、压缩算法、更智能的缓存管理,都能缓解瓶颈,但无法彻底根除。一个瓶颈被缓解之后,应用与模型就会吃掉新增资源。更长上下文、更高并发、多模态模型、越来越复杂的AI智能体,会持续改变内存压力的分布位置。软硬件协同设计至关重要,因为每一层都会影响数据搬运逻辑。
AI基础设施下一阶段的扩容,不再只由算力定义,也不能靠简单加内存解决。更难的工作,是规划推理数据存放在哪里、什么时候迁移、迁移是否比重算更高效。内存墙的内涵已经拓宽:它考验整套系统,能否把分散的内存资源,转化成稳定可控的AI推理性能。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序