
RISC-V用于AI,是突破还是误区?
对并行算力与能效的需求,正在推动芯片设计从通用计算转向AI方向,市场对灵活、模块化、开放硬件的需求随之上升。这一趋势,让RISC-V进入AI加速赛道。可定制硬件能够直接执行AI计算,不再依赖固定架构的CPU设计。近日,Quadric首席营销官Steve Roddy、西门子EDA Tessent产品管理与产品工程总监Francisca Tan、SignatureIP销售与业务拓展高级副总裁Ewald Liess、Breker首席执行官Dave Kelf,围绕相关议题展开讨论。
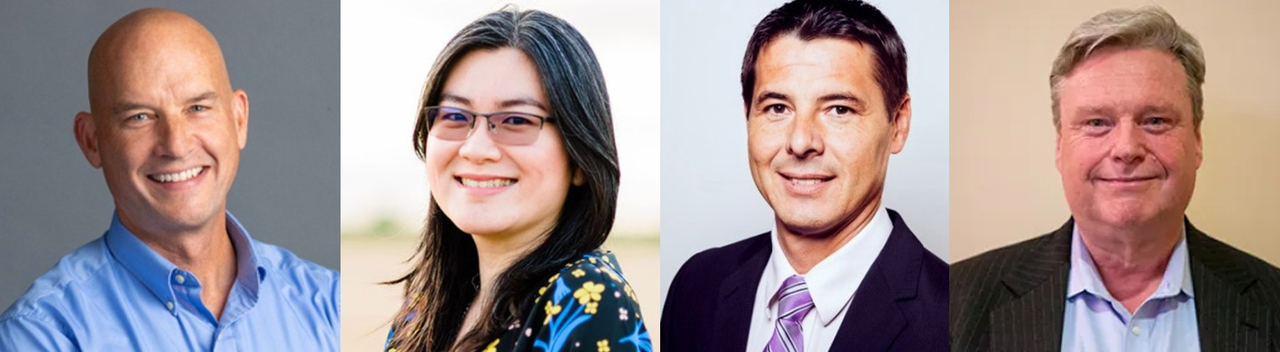
从左至右:Quadric Roddy、西门子EDA Tan、SignatureIP Liess、Breker Kelf
AI模型迭代速度很快,芯片架构师借助RISC-V开发高度专用的扩展指令。站在IP供应商的角度,如何平衡两件事:一方面交付标准化、可复用的IP核,另一方面满足客户面向AI负载提出的高度定制化需求?
Liess:我们认为不需要对IP核本身做定制,我们提供片上网络(NoC)、PCIe、CXL、CHI、AMBA接口。基于这套方案,我们不用改动IP核,需要配置的是片上网络。我们拥有经过预验证的NoC,可通过配套工具完成配置,以此支撑定制化RISC-V的实现。当然,客户可能会修改RISC-V内核、新增指令,但他们一般会保留AMBA总线、CXL、PCIe这类接口,依靠这些接口访问内存等片外器件。这正是我们的价值所在。所以RISC-V开发者可以自由做各类定制开发。
Tan:定制化的验证与确认、可观测性同样重要。在测试和嵌入式分析场景中,负责调试、芯片Bring-up的工程师,需要监控、解析、查看内部信号,或是核验性能指标是否达标。在我看来,随着芯片复杂度持续提高,硬件可观测性会越来越关键。
Roddy:在这个问题上,我的观点和大家不一样。我们认为,用RISC-V搭建AI加速器本身就是一个糟糕的思路,它会直接带来一个难题:一部分计算在具备ALU算力的可编程处理器上运行,另一部分交给外部加速器,系统被切分成两块。一旦做了这种划分,麻烦就来了:需要复杂的编译器调度数据,在加速器和可编程内核之间、依托片上网络来回搬运数据。这个问题会随着规模扩大急剧恶化。加速器规模越大,问题越突出,矛盾不断叠加。举个例子,一个算力100 TOPS的方案,需要搭配16颗RISC-V处理器去驱动大量加速器模块。这就要求高性能互联、完备的验证方案,本质上是在弥补 “从CPU出发做AI加速” 这个底层缺陷。CPU擅长处理指针跳转,它的设计初衷就是应对不确定的任务流,比如40个线程并行,下一个时钟周期执行什么任务无法预判。但AI推理完全不是这种场景:数百万个周期内的计算流程是可预知的,CPU里绝大多数硬件资源都用不上。DSP会更贴近需求,但DSP属于向量运算架构,支持向量对标量、向量对向量运算;而AI里最核心的运算是矩阵乘矩阵。所以我们自研了原生面向矩阵运算的架构。据我所知,市面上只有谷歌数据中心里的大型TPU是同类思路。其余绝大多数方案都存在系统拆分带来的问题,企业投入巨额资金,试图解决这个由底层路线带来的短板。
Kelf:我认同Steve的看法。现在大型AI加速器很常见,架构包含SIMD、SIMT等。这类加速器原本依靠复杂状态机控制,再由主机处理器驱动、调度状态机,指挥加速器工作。我们接触过大小多家公司的四个案例,都发现状态机方案很难用好。于是他们改用RISC-V处理器承担控制功能,原因有很多:开发者可以在RISC-V内核里集成各类运算引擎,也就是Steve提到的向量单元,复用RISC-V向量指令,还可以新增自研指令、矩阵乘法指令;同时增加自研的加载/存储指令,降低模块之间的数据搬运延迟。大家都在尝试改造RISC-V内核,缓解延迟与系统拆分问题。这些方案有的效果不错,有的还不理想,行业仍在摸索。RISC-V的优势在于,开发者可以自由增加自定义指令,同时兼容通用编译器,实现高效的加载存储调度,这是其他处理器很难做到的。Arm等厂商虽然也在部分处理器里加入专用指令,但指令是固定不可修改的。RISC-V在这一点上得天独厚,能够灵活实现这类高性能自定义指令。
针对这些自定义向量指令,EDA工具是否能够适配、自动完成验证?
Roddy:我曾在Tensilica任职17年,当时这套流程就已经实现自动化。当然它的短板是需要支付授权费。RISC-V给了大家一个不用向大厂缴纳授权费的选择。如果只是想要做定制化,Tensilica多年前就已经实现自动化流程:修改指令后,配套编译器、仿真器同步更新,验证也在标准化环境下一并完成。RISC-V的自由度更高,定制边界更宽。我的看法是:如果选用RISC-V,就要深度定制、投入大量人力去搭建配套工具链;如果只是轻度定制,Tensilica的自动化方案会更合适,只是需要承担商业授权成本。RISC-V本身是很有价值的技术,它有自己的适用场景。头部厂商的处理器方案,不会给到这种控制面、CPU层面的灵活度。针对控制任务对处理器做调优,能收获不少收益。但我们不认为适合用它跑推理算力。CPU原本有大量成熟用途,RISC-V CPU可以更灵活、更高效地承接这些任务,成本也低于其他厂商的固定功能CPU。只是不适合把繁重的推理算力交给它。
Kelf:我基本认同。不少企业在自研向量指令、类DSP运算指令。我接触过一些客户,他们采用SIMT阵列做大规模并行运算,最怕并行通道出现分支发散。SIMT架构本身支持分支发散,他们就用RISC-V控制处理器处理发散分支对应的运算,加速器主体继续处理其余计算。RISC-V内核不承担繁重算力,只做少量计算,保证整套系统持续运行、压低延迟。这套方案落地工作量很大,但已有成功案例。RISC-V的商业优势确实是免授权费。Tensilica的技术在DSP、通信场景非常出色,而RISC-V可以实现类似效果,只是需要开发者自主搭建方案、掌握相关技术。一旦落地,RISC-V兼具灵活性与标准化,配套编译器成熟;甚至可以更换合作厂商,在新的RISC-V内核上复用自研IP。这是固定架构、闭源处理器很难给到的灵活度。
Tan:针对自定义指令的调试与分析,尤其是RISC-V场景,我们支持自定义指令追踪调试。RISC-V用户可以指定处理器运行过程中需要追踪的自定义指令,搭建调试环境。我们也是RISC-V联盟成员,数年前捐赠了高效追踪规范E-Trace。这是一种高压缩率的指令追踪方案,适配复杂系统 —— 这类系统数据量大,需要做数据压缩。我们的平台不局限于处理器本身,覆盖整个系统:既可以抓取RISC-V内核的指令流,也可以采集SoC内互联、总线以及指定信号的追踪数据。
Liess:我们聊了很多自定义指令集、ISA层面验证的问题。很多商用IP包会附带测试激励、流量生成器、性能模型这类验证资产。但我更偏向系统视角:高性能系统通常包含多个内核,当RISC-V架构里集成加速器、或是多颗RISC-V核共存时,缓存机制会带来一致性问题。一致性的边界场景、突发流量极易在互联架构里引发死锁。所以我们从片上网络层面,在系统级完成验证,校验数据流转,规避死锁。简单来说:单条指令本身执行正确,但如果计算所需的数据突发流量无法及时送达,芯片依旧会失效。这正是我们重点解决的方向。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序