
存内模拟计算,AI推理的低功耗新路线
存内模拟计算(IMC)有望让AI计算系统实现单运算飞焦级的能效水平。该技术直接在存储单元内完成部分计算任务,省去处理单元与存储单元之间来回搬运数据的环节,大幅降低功耗与延迟。存内模拟计算的研发已有至少十年,采用阻变、相变或电容类材料作为存储单元。闪存无法继续向先进工艺节点微缩,这也推动了该方向的研究。而随着AI兴起,这项技术再度受到重视:交叉阵列可以存储神经网络所需的权重参数。
数字存内计算会把权重以大量0、1信号存储在片上SRAM中;与之不同,模拟存内计算可以只用单个单元存储一组权重,读取速度更快。因此它相比数字方案,处理速度更高、功耗显著更低,尤其适合权重很少变动的推理场景。
基于这一优势,多家初创企业与跨国公司都在研发存内模拟计算技术,用于AI推理,甚至面向数据中心场景。以色列初创公司Weebit Nano推出了一款评估板,搭载用于存内计算的阻变存储器交叉阵列;美国初创企业TetraMem则基于12纳米工艺推出存内计算芯片,是目前工艺最先进的一款。
“AI的能效问题不能一概而论。在笔记本、数据中心、机器人等不同部署场景下,问题表现各不相同,每种场景都有对应的能效门槛,只有达标才能释放实际能力。”EnCharge AI首席科学家Shwetank Kumar表示,该公司研发了基于电容的存内模拟计算架构。
“最核心的瓶颈就是数据搬运。在传统架构里,数据不断在存储和计算单元之间来回传输。把一个32位数据从片外DRAM读出,消耗的能量大约是直接运算的200倍。在AI任务中,数据搬运占到总功耗的60%–80%。我们整个行业都在关注算术运算,但真正的能耗大头,其实是搬运数据。”
模拟计算本身存在公认难题:噪声、精度限制、工艺偏差。但神经网络天然具备抗噪声特性,不需要64位精度,而且绝大多数运算都是矩阵乘法,这类运算刚好可以和模拟运算天然匹配。研究人员也在开发容错方案,克服模拟器件带来的各类缺陷。
Weebit Nano
Weebit Nano从法国CEA-Leti获得阻变存储器(ReRAM)技术授权,并将该技术对外授权给多家客户,用于非易失性存储。目前已有三家客户通过代工厂完成芯片流片;德州仪器(Texas Instruments)和安森美(onsemi)都在把这项技术移植到自家工厂,用于下一代嵌入式存储器。
该技术最初的目标是嵌入式芯片存储,但面向AI的存内模拟计算需求热度高涨。Weebit Nano现已推出评估板,供科研人员开展技术研究。
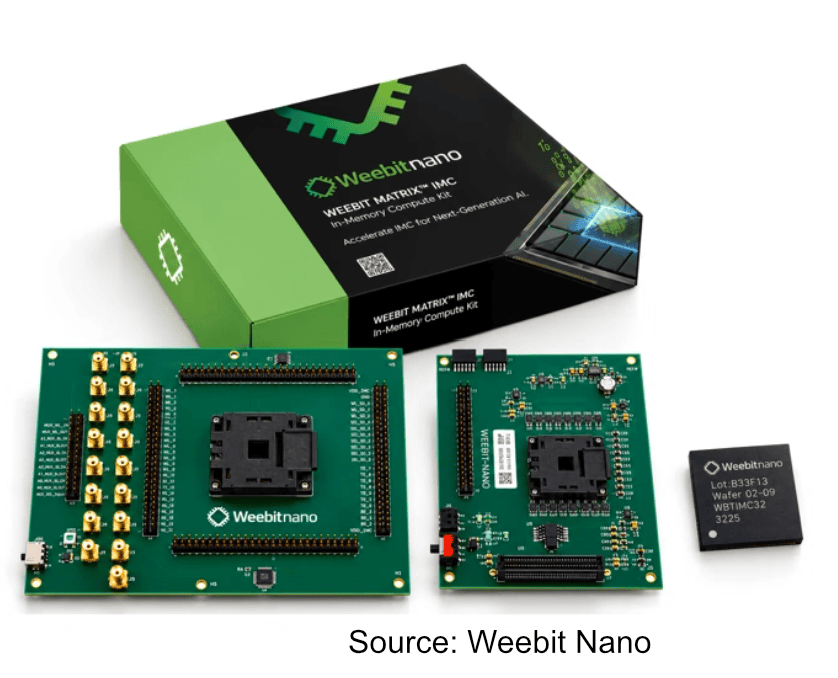
Weebit Nano的ReRAM存内模拟计算评估板与快速开发板
“存内计算已经发展多年,这显然是AI的下一阶段,是一种全新的计算方式。对于ReRAM来说,它依靠电阻特性,利用电导与电压完成乘法、权重矩阵运算,并且在同一条位线上累加,输出结果就是乘累加(MAC)结果,不需要时钟、也不需要搬运数据。”Weebit市场与业务拓展副总裁Eran Briman说,“这也是我们相比GPU能够实现百倍性能提升的原因。”
“当然,它并不适用于所有AI场景。我们聚焦推理场景,推理要求低延迟,权重基本不需要更新,这正是非易失存储的优势赛道。”
“过去两三年,不断有行业客户希望用我们的ReRAM做推理和神经形态计算,这也是我们推出评估板的动因。我们会从科研人员那里收集大量反馈。他们大多关注边缘端小模型场景,这类场景对延迟非常敏感,比如车载传感器、工业设备,功耗指标更是重中之重。”
“我们也希望把这项技术推向数据中心,但数据中心需要更先进工艺节点。我们目前还没达到,但ReRAM本身具备持续微缩的潜力。” 他说,“我们基于FinFET的分析结果比预期更好,台积电也正在把阻变存储器移植到6纳米。暂时还达不到2纳米,这也是目前该技术更多落地在边缘端、而非数据中心的原因。另外数据中心的模型规模更大,需求也不一样,不过这套方案可以适配各类应用。”
公司的目标是研发一套存内计算设计方案,对外授权给客户。“如果这项技术能够持续迭代,我们依托产业生态,最终推出自研存内计算产品,这是终极目标。我们不会和授权客户竞争,所以采用授权模式,不是直接交付可集成方案。客户可以拿到授权,用在自研控制器、CPU、GPU或者SoC里。移植到6纳米还是2纳米,由客户自行决定,属于远期规划。”
“我们面向科研人员提供两种套件:一种是面向系统级AI推理的快速开发套件;另一种是器件表征评估套件,使用者可以访问每一个ReRAM单元,直接读写信号、调试编程机制。”
快速开发套件搭载带ADC的FPGA,搭配独立的AMD Zynq开发板与十颗封装裸片,搭建出32×32交叉阵列。开发者可以基于这套阵列,运行适配存内模拟计算的AI算法与模型。
12纳米存内计算芯片
TetraMem现已基于多级阻变存储器技术,完成12纳米存内模拟计算SoC流片。这款MLX300是单芯片加速器,支持音频、视觉以及小语言模型,片上最多可承载6400万INT4参数,无需外接DRAM存放模型权重。这款SoC目标能效超过50–80 TOPS/W,为下一代AI推理带来显著能效提升。
“TetraMem的架构把存储与计算融合在一起,代表AI计算一条全新的技术路线。”TetraMem首席执行官、联合创始人Glenn Ge表示。
MLX300是在MLX200/MLX200M基础上迭代而来,后者采用商用22纳米工艺。
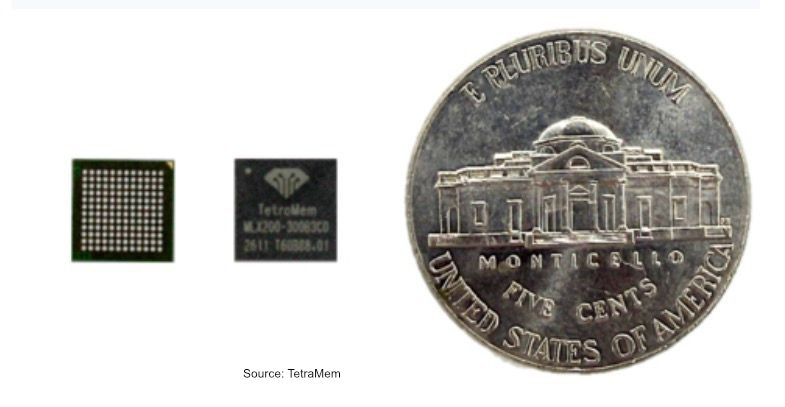
TetraMem MLX200存内模拟计算芯片
“TetraMem在存内模拟计算上的探索,正是释放下一代AI性能与能效所需要的大胆创新。” 新思科技(Synopsys)EDA产品管理与战略高级副总裁Sanjay Bali说道,新思为该项目提供设计工具。
MLX200采用台积电22纳米ReRAM工艺,将多级阻变存储阵列与混合信号计算引擎集成,直接在存储内部完成向量矩阵乘法。配套评估套件很快推出,面向智能手表、健康监测设备、AR眼镜这类穿戴式AI设备,以及需要本地智能、不依赖云端的物联网边缘节点。
该公司还和南加州大学、马萨诸塞大学阿默斯特分校的研究者合作,研发耐高温阻变存储器件,可在最高700℃条件下稳定工作。器件采用石墨烯 / 氧化铪 / 钨忆阻器,在该高温下稳定运行,开关电流比大于10³,数据保存时长超过50小时,可擦写循环次数可达10⁹次。
这项技术可以让嵌入式芯片、数据中心芯片在高温环境下稳定工作。
INTERA
西班牙巴塞罗那的INTERA研发了一套全新架构,克服了其他模拟存内计算方案的短板,核心是一款完全基于CMOS的有源电路单元:可编程电流脉冲单元(PCPC)。每个PCPC可以生成可编程电流,代表突触权重;激活时长用来编码输入信号。电流幅值与激活时长共同作用,实现权重和输入的乘法运算。
每个PCPC输出可编程电流代表突触权重,激活时长编码输入信号。电流幅值与持续时长耦合,完成权重与输入值相乘,产生的电荷在交叉阵列内累加,实现高度并行的向量矩阵乘法。
一大核心优势:这套存内模拟计算方案完全兼容标准CMOS制造工艺。对比依赖新型存储器件的方案,它的技术风险与量产风险更低。
潜在应用包括数据中心AI处理、边缘计算设备、机器人、自主系统以及物联网平台。
EnCharge
EnCharge AI也选择了一条差异化的存内模拟计算路线。“我们走的路线和别家完全不同,依托电容的物理特性,直接在存储阵列内完成矩阵运算。”EnCharge AI的Kumar说,“和以往模拟方案最大的区别在于,标准CMOS工艺里的电容本身具备极高的固有精度。这不是猜想,已经在高精度20位模数转换器(ADC)中得到验证,几十年以来,MRI设备、飞机、汽车等高可靠场景都在使用这类ADC。我们的创新,就是把电容的高精度能力,从ADC拓展到AI计算。”
去年,该公司推出首款AI存内计算加速器EN100,面向笔记本电脑和工作站实现商业化。“EN100代表AI计算架构的一次重大转变,背后依托软硬件创新,经过多代硅片验证,大幅降低技术风险。”EnCharge AI首席执行官Naveen Verma表示。
这是系列芯片的首款产品,架构经过优化,在降低功耗的同时高效处理AI任务。M.2卡版本在8.25瓦功耗下,AI算力可达200 TOPS以上;面向工作站的CPCI Express卡可搭载四颗加速器,总算力接近1 PetaOPS。
配套软件可以适配不断迭代的各类模型,兼顾效率,集成专用优化工具与高性能编译器,支持PyTorch、TensorFlow主流框架。
“EN100真正的价值,是让合作伙伴轻松获得高能效AI推理能力,助力他们实现AI路线图。”EnCharge AI产品与战略高级副总裁Ram Rangarajan说,“在终端平台上,EN100可以在设备本地部署复杂AI能力,催生新一代智能应用,响应更快、安全性更高,同时支持个性化。”
数十年的研发积淀
惠普、IBM等企业多年来一直在研究这类技术。
IBM研究团队正在研发可规模化硬件,包含3D存内模拟架构,用于大模型;同时研发适配小型边缘模型的相变存储器,以及加速Transformer注意力机制的算法,目标是把这项技术从实验室推向芯片产品。
一份IBM研究院的研究表明,存内模拟计算芯片非常适合运行前沿的混合专家模型(MoE),多项指标优于GPU。混合专家网络每一层里的各个专家,可以分别映射到3D非易失存储的不同物理层。大量仿真与基准测试显示,这套映射方案在边缘AI场景下运行MoE模型时,可以实现高吞吐、高能效。
“把存内模拟计算拓展到三维,哪怕是大型Transformer架构,所有模型参数也可以全部存放在片上。” 首席研究员Julian Büchel说。在MoE模型中,神经网络的一层可以拆分为多个子层,每个子层叫做一个 “专家”,专门处理一部分数据。输入数据到来时,路由模块会决定交给哪一个或者哪几个专家处理。团队用两套标准MoE模型做性能仿真,仿真硬件的表现优于当前最先进的GPU。
“这样一来,神经网络的扩展能力更强,我们可以用接近小型网络的算力开销,部署一个规模庞大、能力很强的神经网络。” 项目负责人Abu Sebastian说,“不难理解,这也大幅降低推理所需算力。”
仿真结果显示,在运行MoE模型时,这套3D存内模拟计算架构的吞吐、面积利用率、能效都高于商用GPU。能效差距最为突出,因为GPU要在存储和计算单元之间来回搬运权重,消耗大量时间与功耗。
团队还验证了相变存储器(PCM)用于边缘AI推理的可行性:利用硫系玻璃的导电特性存储模型权重。向玻璃施加更高电压,材料会从晶态转变为非晶态,导电性下降,以此改变矩阵向量乘法的运算结果。
“边缘设备同时受功耗、成本、面积、灵活性多重约束。” 研究员Irem Boybat表示。团队设计了一款神经处理单元,混合相变存储模拟加速器与数字加速器,分别适配不同精度需求。
Boybat介绍,这套灵活架构可以运行多种神经网络,团队测试了面向移动端优化的Transformer模型MobileBERT。在MobileBERT推理基准测试中,该神经处理单元性能优于市面上低成本加速器,接近部分高端智能手机的水平。
Sebastian表示,这项研究朝着一个目标迈进:未来存内模拟计算器件可以低成本量产,AI模型全部权重都存放在片上。
目前已有Transformer架构在存内模拟计算芯片上落地验证,依靠静态权重完成矩阵向量乘法,精度和数字处理器相当。
容错架构
与此同时,惠普联合香港大学研究者,基于惠普忆阻器技术开发了一套存内模拟计算容错架构。模拟系统本身容易受器件失效、参数偏差影响,限制精度与可靠性,这套方案可以解决该问题。现有的冗余、重训练等容错手段,在很多场景下效果有限、难以落地。
研究者提出一种无差错矩阵表征方案:把目标矩阵拆解为两个可调节子矩阵的乘积,写入模拟硬件。这种间接自适应表征方式,通过数学优化避开故障器件,同时省去差分配对结构,提升计算密度。
在离散傅里叶变换矩阵的测试中,即便器件故障率达到39%,这套忆阻器系统依然可以实现99.999% 以上的精度。在无线通信原型中,误码率下降56倍;在大型矩阵运算上,计算密度提升超194%,能效提升超164%,优于现有主流方案。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序