
特斯拉重画芯片版图,SI6瞄准80倍算力,Dojo 3要上天
近日,特斯拉更新了自家的AI加速器路线图,第六代推理芯片SI6把目标定在现有车型芯片80倍的算力上,被重新启动的Dojo D3则把部署场景写上了太空。比这两组数字更早被外界注意到的,是命名本身:从这一版路线图起,“人工智能”被“超级智能”替代,AI4、AI5、AI6这一串叫了三年的名字,一并改成了SI4、SI5、SI6。
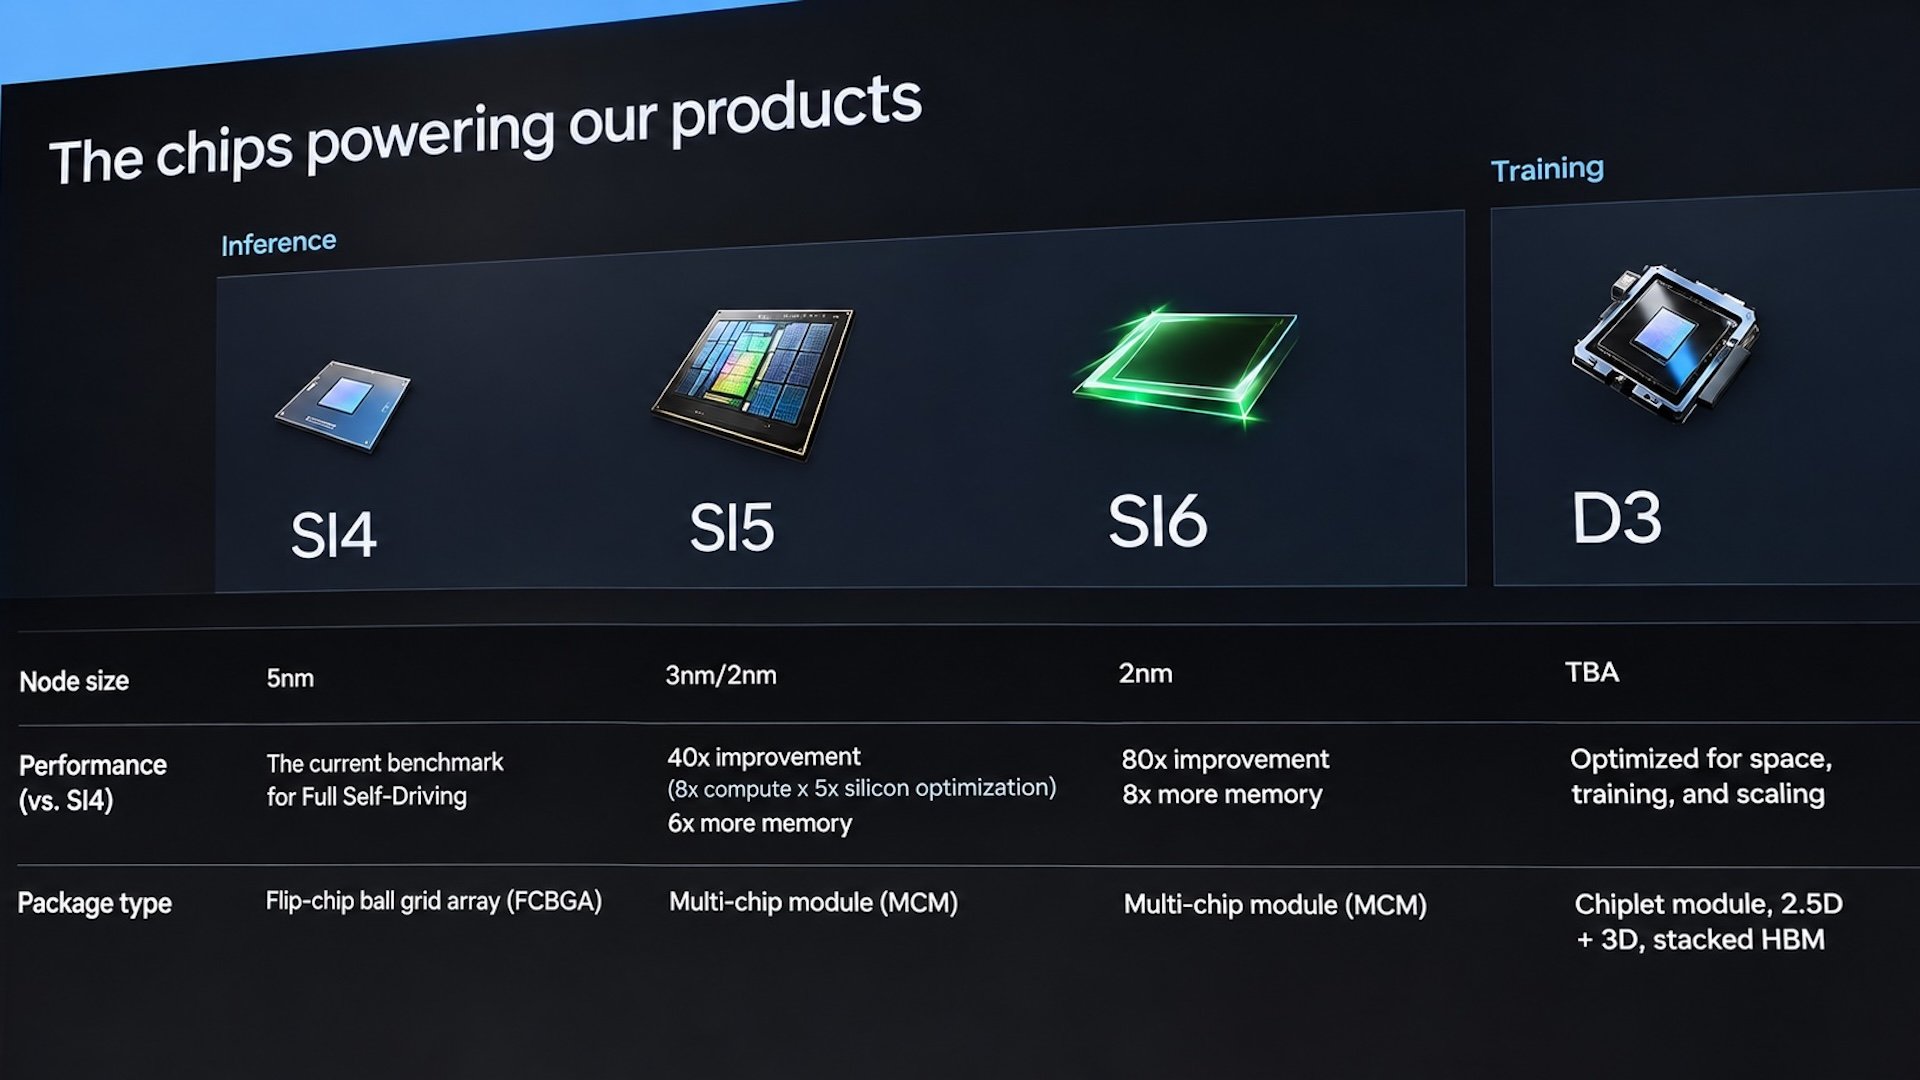
据了解,特斯拉这次把新命名体系追溯应用到了旧款芯片上。目前量产车型上那颗原本叫HW4、后来叫AI4的芯片,在路线图里已经写成SI4;尚未放量的AI5变成SI5,仍在设计阶段的AI6变成SI6。命名变动不只停留在PPT上,特斯拉车主手册在10月下旬已经开始把“FSD Computer”改成“SI Computer”。出于同样的理由,马斯克近期也确认,SpaceX旗下的SpaceX AI将更名为SpaceX SI。一家车企把自己最强的算力资产从“智能”抬到“超级智能”,语气变化背后是产品定位的变化:特斯拉希望外界把这套硅片读成基础设施,而不是汽车零部件。
最受关注的一条参数落在SI6身上。按照路线图,这颗芯片的算力目标是SI4的80倍,内存容量则是SI4的9倍,达到144GB,采用2nm级制程,封装延续多芯片模块设计,预计2029年至2030年推出。代工侧已经落定,特斯拉与三星晶圆代工签署的协议覆盖到2033年,公开报道的金额约为165亿美元,SI6不在Terafab用英特尔14A制程生产的规划之内。
80倍这个数字需要放在基准上看。特斯拉从未正式公布SI4的绝对算力、内存容量与功耗,外界只能借马斯克此前的说法推算:HW4性能是HW3的3倍至8倍,而HW3的官方算力为72 TOPS,据此SI4大致落在216 TOPS至576 TOPS区间。把这套基准套到SI6上,得到的估算值约在17280 TOPS至46080 TOPS之间,也就是17.28至46.08 POPS。问题在于SI6支持哪些数据格式尚无披露,基准本身也是估值,这组换算只能当作参考坐标。真要对标,英伟达Rubin GPU的推理算力为50 NVFP4 PFLOPS,训练算力35 PFLOPS,FP8与FP6算力17.5 PFLOPS,而Rubin已经在向客户交付,SI6的时间表还停在2029年之后。同一张表上,一边是已经出货的产品,一边是四年后的目标,这中间的差距比倍数更值得记。
夹在两者之间的SI5是眼下更接近现实的一代。路线图给出的目标是SI4的40倍算力,内存96GB,为上一代的6倍,由台积电3nm与三星2nm分别流片,同样转向多芯片模块封装,功耗预计在250W至800W之间。马斯克此前解释过这40倍的来路:制程升级和执行单元增加带来8倍计算能力,硅片层面的优化再贡献5倍。按前述基准估算,SI5的算力区间在8640 TOPS至23040 TOPS。250W到800W的功耗跨度也说明一件事,这颗芯片在不同场景下会被放在完全不同的散热与供电框架里,车端、机器人端和数据中心端拿到的可能不是同一个版本的性能释放。
路线图里真正带有转折意味的,是Dojo的回归。马斯克2025年8月砍掉了整个晶圆级Dojo项目,2026年8月又表示SpaceX和xAI的地面及太空数据中心会全部采用英伟达硬件。如今第三代D3重新出现在蓝图上,架构却换了一副骨架:以芯粒为基础,采用2.5D与3D封装,搭配堆叠式HBM高带宽内存。第一代D1走的是另一条路,靠分布式片上SRAM支撑,通过晶圆级封装把25颗D1处理器连成一片,整片晶圆提供11GB SRAM,单颗芯片440MB,片上带宽约10TB/s,算力362 TFLOPS。
从SRAM转向HBM,指向的是容量焦虑。大模型的参数、激活值和中间计算结果都在吞噬内存,SRAM在容量维度上已经撑不住这个量级,HBM则让扩容变得相对容易,代价是延迟、带宽、封装和功耗上的一整套新权衡。特斯拉是否完全放弃晶圆级集成,外界得不到答案。一种可能是逻辑芯片仍用晶圆级封装互连,再在其上堆叠定制HBM模块;另一种可能是特斯拉认定晶圆级集成成本过高,只在SRAM主导的架构里才有价值,而把HBM压在晶圆级互连之上会同时抬高设计复杂度、散热难度、制造难度与良率风险,长期可靠性也会被拖累,最终都由成本买单。后一种判断下,D3走传统芯粒架构的概率更高。
D3最不寻常的一句话是优化方向:太空、训练与规模扩展。把太空写在训练芯片的优化目标里,意味着至少部分型号需要面对抗辐射设计,也意味着特斯拉与SpaceX的轨道数据中心计划开始向硅片层面下沉。这与Terafab的分工吻合,D3也就是AI7,被放在Terafab与英特尔工艺合作的路径上,商用代工厂很难为单一客户长期维护一套抗辐射的工艺库和器件模型,这也是它不去三星、台积电的原因。只是D3的算力、内存容量、制程和研发时间表全部空白,路线图给出的只有方向。
把这几条线放在一起看,特斯拉正在做的事已经超出车企自研芯片的范畴:推理侧用SI4、SI5、SI6搭出一条以SI4为统一基准的性能阶梯,每一代都挂上一个明确的倍数,训练侧用D3补齐被英伟达填过的空位,再把这套算力一路铺到车内、机器人、地面数据中心和轨道卫星上。这套体系的说服力不取决于80倍这个数字有多响,而取决于2029年前后真正流出来的那颗芯片,能不能对得上今天这张表。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序