
RTX 5080光追暴增221倍,微软重构API
近日,微软DirectX 12 Agility SDK 1.722预览版的一项极端实测显示,在NVIDIA RTX 5080上启用新增的Clustered Geometry(聚类几何)功能后,光线追踪场景的性能实现了跨越式跃升。测试者Osvaldo Pinali Doederlein提醒,该示例程序缺少LOD系统,极端提升幅度不能直接外推到实际游戏中。
这组数据的关键意义在于,它直接点破了当前光追渲染的真实痛点:真正拖慢帧率的往往不是GPU算不出光线,而是每一帧重新构建几何体加速结构所产生的高昂时间与显存开销。API层的改动,正是为了消除这部分底层损耗。
光追性能受制约,加速结构重建成主要开销
过去,光追的性能瓶颈往往被归结为GPU能处理多少条光线,但这次实测揭示了另一种结果。
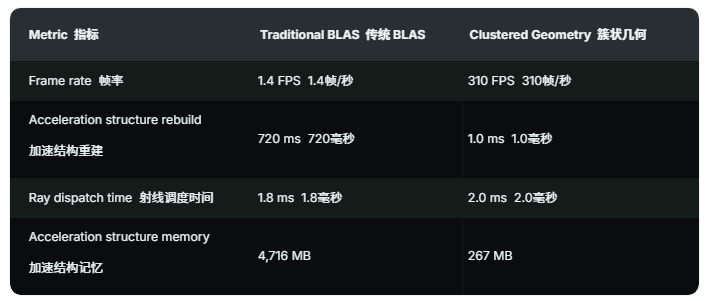
在极端压力测试场景中,启用新功能前,RTX 5080的帧率仅为1.4 FPS;启用后,帧率直接跃升至310 FPS,整体帧率提升幅度高达221倍。 光线调度时间从1.8毫秒微增至2.0毫秒,几乎没有变化。真正的性能跃升在于加速结构的重建时间,从720毫秒压缩至1.0毫秒。同时,加速结构占用的显存从4716 MB骤降至267 MB,降幅达到94.3%。
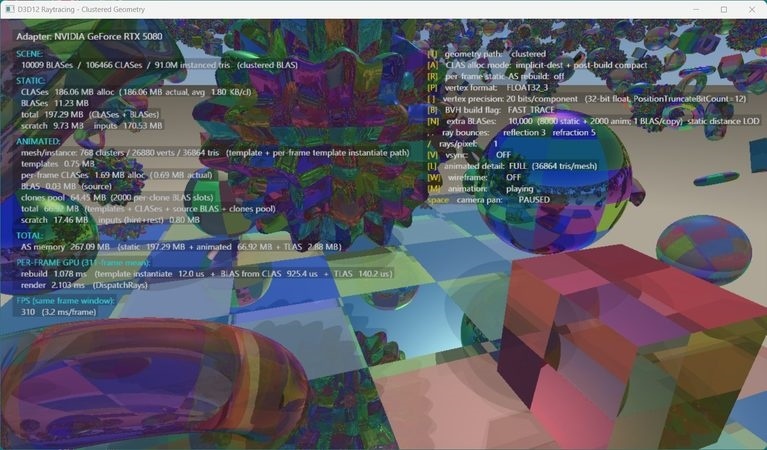
传统DXR的工作方式是,每一帧都需要为场景中的几何体重新构建或更新底层加速结构(BLAS)和顶层加速结构(TLAS)。在复杂场景中,这会产生极其庞大的显存带宽压力,导致GPU的计算单元大量空转等待数据。
Clustered Geometry的核心思路是把几何体预先聚类成簇,以簇为单位构建加速结构,从而大幅减少需要重建的节点数量和显存占用。结合PTLAS(分区顶层加速结构),系统可以把TLAS拆分成多个可独立更新的分区,避免每一帧全量重建,大幅缓解了显存容量与带宽压力。对于大规模场景来说,这比单纯的算力提升更具实际意义。
API优化见效,底层硬件架构差异决定上限
除了绝对数值的飞跃,这次实测还提供了一个非常直观的横向对比,直接反映了软硬协同的差异。
在禁用该功能时,RTX 5080的帧率为1.4 FPS,而AMD RX 9070 XT为1.7 FPS,两者差距极小。但在启用新API功能后,RTX 5080跃升至310 FPS,RX 9070 XT则跑出了91 FPS。RTX 5080的帧率表现为RX 9070 XT的3.4倍。
这种差异的核心在于,两家GPU底层硬件对特定工作负载的适配能力不同。业内分析指出,NVIDIA自Turing架构起就在硬件底层引入了专用的RT Core以及高效的BVH压缩算法。这种物理级别的压缩能力,使得GPU在处理由Clustered Geometry生成的更紧凑的数据结构时,能获得更高的吞吐效率。相比之下,AMD的RDNA架构虽然同样支持硬件光追,但在应对超大规模、非规则几何体聚簇时,底层指令集和显存控制器的适配效率存在明显差异。
这说明,同一项API优化在不同GPU架构上的落地效果并不均等。软件优化释放的硬件潜力,取决于底层芯片是否为这类负载预留了相应的硬件压缩和调度能力。
图形性能路径重构,从依赖制程微缩转向API优化
从行业视角来看,图形性能的提升路径正在发生底层逻辑的转变。当制程微缩和晶体管堆叠的边际收益逐渐放缓,API层面的结构性优化,正在成为释放GPU潜力的关键手段。微软把Clustered Geometry和PTLAS放进DirectX 12的预览SDK,意味着这项能力将逐步向所有支持的硬件开放,而不是某一家GPU厂商的专属优化。
对于图形工作站、工业仿真、数字孪生等场景而言,加速结构重建时间和显存占用的数量级下降,比峰值帧率更有价值。在过去,汽车制造的数字风洞模拟或大型工业CAD渲染,往往因为显存容量不足或加速结构重建开销过大,被迫采用降级渲染甚至延后计算。
现在,这些场景可以在单张显卡、更低的显存配置下完成实时光追渲染,这直接降低了中小型设计团队和企业级用户的硬件采购门槛,也为工业软件的高效迭代提供了底层支撑。
当然,从预览版SDK到各大游戏引擎和工业软件的全面适配,还有一段路要走。Work Graphs在近期被微软从Shader Model 6.10中移除,也说明API层面的路线选择本身存在试错和调整。但Clustered Geometry指向的方向是清晰的,光追的效率竞争,正在从比拼峰值算力,转向优化复杂场景的组织与构建开销。
未来的竞争不再局限于晶体管规模或理论浮点算力,而是延伸至API规范、底层驱动与微架构设计的交汇点。谁能针对复杂图形负载实现更高效的指令级调度与软硬协同,谁就能在大规模实时光追计算中,换取更优的能效比与单帧渲染成本。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序