
一颗CPU拆成六块硅片,英特尔Nova Lake-H真身曝光
英特尔下一代移动处理器Nova Lake-H的封装照片,最近又在硬件圈里流传开来。爆料人momomo_us放出了一张低分辨率SoC照片,虽然没有第三方标注,但也能看清封装上芯粒的排布方式。
跟现役的Panther Lake相比,这颗芯片最直观的变化不在于核心数量(H版本依然是4个P核、8个E核加4个LPE核,合计16核),而在于封装内部芯粒的数量和分工方式。
Nova Lake-H采用了六颗芯粒,其中四颗是承担实际功能的功能芯粒,另外两颗是不带任何电路的被动芯粒,纯粹用来维持封装结构的完整和平整。这四颗功能芯粒的规格和工艺,也随着照片一起浮出了水面。
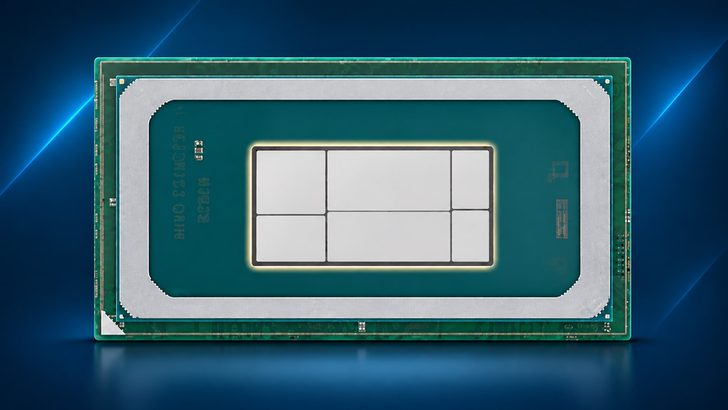
(来源:爆料人momomo_us)
六颗芯粒,三种工艺
结合照片细节,先来拆解功能芯粒的具体构成:
计算芯粒(Compute Tile)是左上角那块,面积约55mm²,承载4个P核和8个E核。这颗芯粒的工艺归属是整颗芯片里最值得注意的:它由台积电N2P代工,而不是英特尔自家的18A节点。
SoC枢纽芯粒(Hub/SoC Tile)是中央偏上、面积最大的一块,约72mm²,采用英特尔18A-P工艺。4个LPE核就放在这颗芯粒上,同时它还集成了内存控制器等系统级功能。LPE核和主计算核不在同一颗芯粒上,意味着它们不共享L3缓存,但由于SoC芯粒自带内存控制器,LPE核对系统内存的访问延迟反而很低。
外围控制芯粒(Peripheral Controller Tile)紧挨着SoC芯粒,面积约58mm²,同样是18A-P工艺,负责平台层面的接口和控制逻辑。
图形芯粒(Graphics Tile)位于右上角,面积最小,仅26mm²,采用英特尔Intel 3-E工艺,集成4个Xe3 GPU核心。这颗芯粒并不是固定配置,爆料显示它可以替换成更大的图形模块,最高支持12个Xe3P核心。
两颗被动芯粒,则分别位于图形芯粒和计算芯粒旁边。它们没有晶体管,只负责填充封装上因芯粒尺寸不一而留下的空隙,保证整个封装在受力时不会因为局部悬空而变形。在H版本上,被动芯粒的合计面积约45mm²;在尺寸更大的HX版本上,被动芯粒合计约106mm²,封装尺寸也从H的12×23mm拉长到了12×30mm。
一颗CPU拆成六份
为什么要把一颗芯片拆成六块硅片?
六颗芯粒、三种工艺混搭,这套方案最直接的逻辑,就是把不同的功能放在“最适合它”的制程上。
具体来说,计算核心对性能和能效的要求最高,所以交给了台积电N2P。这是目前移动端能拿到的最先进节点之一,也是AMD下一代移动处理器会采用的同级别工艺。图形模块用Intel 3-E,成熟、成本可控,同时Xe3架构本身的能效比已经足以覆盖轻薄本的图形需求。SoC和外围模块采用18A-P,英特尔自家工艺在接口、内存控制器这类对绝对性能不敏感、但对成本和供应稳定性敏感的区域,找到了用武之地。
这种分工带来的一个隐性收益,是面积成本的精细化。每一平方毫米的先进制程面积都是钱,把LPE核、内存控制器和外围逻辑从昂贵的N2P计算芯粒上挪走,单独放在18A-P上,本质上是在用更便宜的制程承担“非核心但必需”的功能。
另一个收益,是产品分层的灵活性。H版本和HX版本共享图形、SoC、外围三颗芯粒,只在计算芯粒和被动芯粒上做区分。HX的计算芯粒拉到104mm²,容纳8P+16E共24核,封装随之加长。图形芯粒也可以按需替换,从4个Xe3核心一路覆盖到12个Xe3P核心。英特尔不需要为每一个SKU重新设计一颗单片芯片,只需要调整芯粒的组合方式。
被动芯粒,不是浪费
两颗被动芯粒是这套设计里最容易被误解的部分,乍看起来,在寸土寸金的封装里放两块没有电路的硅片,是一种浪费。但实际上,被动芯粒的存在恰恰是为了让封装在“不浪费”的前提下保持可扩展。
如果计算芯粒和图形芯粒的尺寸差异导致封装出现空白,结构强度就会出问题。用被动芯粒填平这些空白,比重新设计一颗尺寸完全匹配的单片芯片要便宜得多。更重要的是,这些被动芯粒的位置可以被主动芯粒替换,图形旁边的被动芯粒可以换更大的GPU,计算旁边的被动芯粒可以换第二颗计算芯粒。封装本身变成了一个可以“插槽化”的基座,而不是为某一颗芯片定死的壳子。
Nova Lake-H的六芯粒方案,与其说是一次“技术炫技”,不如说是英特尔在移动芯片上的一次务实的分工实验。它不再追求把所有功能塞进一颗完美的单片芯片,而是承认不同的功能模块有不同的成本曲线和工艺需求,然后用封装把它们拼在一起。
对于普通用户来说,不论六颗芯粒,还是三颗芯粒,在使用中大概率感知不到。而真正会传达到体验层面的,是这套模块化设计能不能让英特尔在同一个移动产品线里,更灵活地覆盖从轻薄本到高性能笔记本的不同档位,同时把价格控制在有竞争力的范围内。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序