
台积电CoWoS-S对AI产业链的战略意义
在AI芯片的世界里,有一个越来越清晰的共识:制程微缩的红利正在放缓,而先进封装正在成为延续算力增长的核心引擎。
一颗大模型训练芯片,如果只有GPU,没有高带宽内存(HBM)的紧密配合,就像一台没有油箱的跑车。而把GPU和HBM以极短距离、极高密度连接在一起的技术,就是台积电的CoWoS(Chip-on-Wafer-on-Substrate)。从英伟达的Hopper、Blackwell到Rubin,从AMD的MI系列到云厂商的自研ASIC,几乎每一颗高端r芯片的背后,都站着CoWoS的身影。
台积电将CoWoS封装技术划分为三类,分别为CoWoS-S、CoWoS-R与CoWoS-L。其中,CoWoS-S凭借其在高性能计算领域的卓越表现,已成为人工智能(AI)时代不可或缺的核心基石。
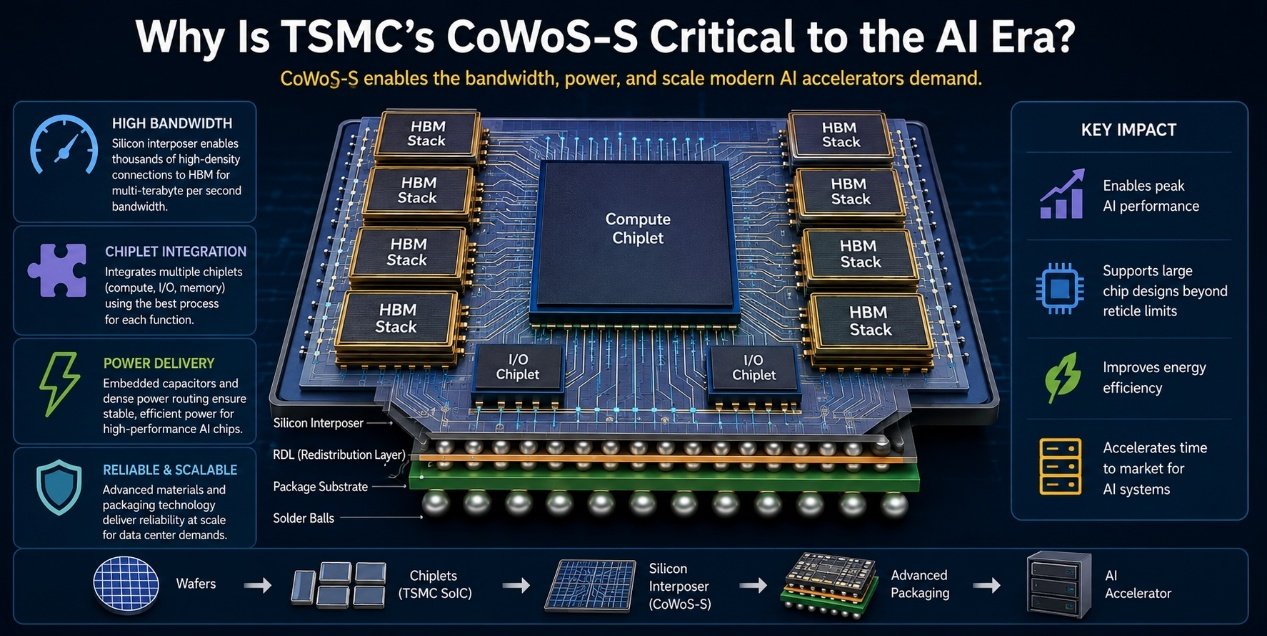
带宽鸿沟:普通基板为什么不够用了?
AI训练与推理的本质,是在处理器与显存之间搬运海量参数、激活值和KV缓存。一颗前沿GPU拥有巨大的算术吞吐能力,但这些单元只有在显存带宽充足、通信延迟够低时才能释放有效性能。传统有机基板无法在处理器与多组HBM堆叠之间提供足够细间距的互连线。
CoWoS-S采用硅中介层,其布线密度更接近芯片内部金属层,从而在逻辑芯片与HBM之间建立数千条短而宽的并行通道,实现每秒数太字节(TB/s)级的显存接口,且每比特传输能耗低于板级存储方案。
超越光罩极限:Chiplet异构集成
硅中介层还让系统突破了光刻光罩的尺寸限制。制造一颗巨大的单片die,通常会受曝光面积、缺陷密度、良率和成本等多重制约。CoWoS-S允许设计人员将系统拆分为计算、输入输出、缓存、网络或专用chiplet,再在单颗封装内集成已知合格芯片(KGD)。
每个组件可选用最适合其功能的制程节点,例如计算tile采用先进制程,接口或模拟功能则用成熟节点。这种异构方式在不牺牲封装级带宽的前提下,提升了良率、设计复用度、产品分段灵活性和上市速度。
供电与热机械:真正难以复刻的门槛
供电同样关键。AI加速器抽取极大电流并经历快速负载瞬变,电压骤降会降低时钟频率、破坏运算,或迫使设计采用保守的功耗余量。CoWoS-S在硅中介层中集成了密集的供电路由结构和嵌入式深沟槽电容(DTC),这些电容在逻辑芯片附近提供本地电荷,在主板电容和封装元件响应过慢的频段上改善电源完整性。短互连还降低了寄生电阻与电感,支持高功率下稳定工作。
热与机械工程则让这一平台更难被复制。一块承载多颗die的大尺寸中介层,必须经受晶圆加工、微凸点键合、注塑成型、基板附着、热循环以及数据中心长期运行。硅、铜、底填胶、塑封料和有机基板之间热膨胀系数差异会产生翘曲与应力。台积电的价值不仅在于中介层概念本身,更在于对材料、组装精度、良率、测试、可靠性和大规模量产全流程的掌控。
规模与成熟度:战略瓶颈如何形成
据台积电披露,该平台支持的硅中介层可达约3.3倍光罩尺寸,第五代实现约2500平方毫米的中介层。这种尺寸把封装变成了系统级集成平台。
此外,成熟度也降低了商业化风险。客户获得的是一整套生态,包括设计规则、中介层制造、die组装、散热方案、电气验证和量产测试。这种集成缩短了调试周期,使多die加速器能够在超大规模下制造。
先进逻辑晶圆和HBM或许都能买到,但一颗AI加速器必须等到这些组件被组装、键合、测试并认证为一颗可靠封装后才能出货。封装产能因此决定了云厂商部署新算力集群的速度,也反向塑造了加速器架构。因为中介层面积、HBM布局、凸点间距、功率密度、基板尺寸和散热极限,必须在量产前数年就协同设计。
结语
站在AI算力爆发的当下回头看,CoWoS-S的不可替代,从来都不只是某一款封装技术的单点胜利。它背后是整个半导体行业的共识转向:晶体管微缩的价值仍在延续,但决定算力上限的关键,早已落到多芯片、存储、供电与互联的集成效率之上。当封装彻底跳出“后端工艺”的定位,成为计算架构不可分割的一部分,那些分散制造的硅片,才真正被拧成了一个紧耦合、高带宽、高能效的完整算力系统,托举起AI时代最核心的算力底座。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序