
英伟达跑出104量子比特纪录,硬件需求直降90%
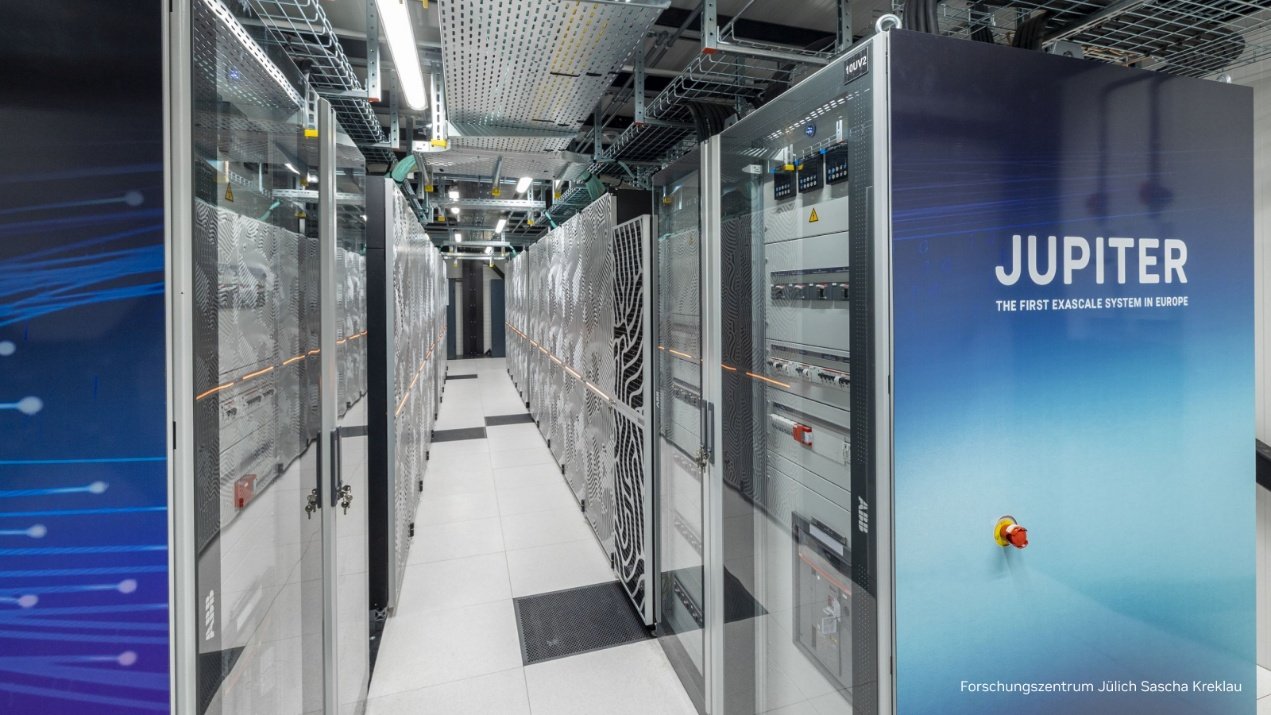
当地时间10月19日,NVIDIA宣布在欧洲首台E级超算JUPITER上完成迄今规模最大的容错量子计算模拟:研究人员以104个量子比特的完整细节,复刻了一台真实量子处理器在噪声环境下的运行过程。
这次模拟跑在8192颗NVIDIA GH200超级芯片组成的集群上,验证了一种被称为“魔法态培育”的容错路线。相比以往方案,它构建有用量子计算机所需的物理量子比特数量减少了90%。
对尚处于硬件摸索期的量子产业而言,这意味着可以先在超算上“跑通”设计、再动手造机器,把通往实用化的路程缩短数年。
(来源:英伟达官网)
破纪录的104量子比特,到底意味着什么?
容错量子计算被视为实现真正有用量子计算的必经之路,但它对系统规模的要求极高,必须在噪声干扰下稳定完成运算,这往往需要成百上千个物理量子比特来“养”出一个可靠的逻辑量子比特。
过去,研究者并非没有做过模拟。早在JUPITER之前,尤利希超算中心团队就曾完成过一次开创性的量子模拟,但那是在50个量子比特、理想无噪声条件下的简化推演。而这次104量子比特模拟的关键差异在于,它不再假设世界是干净的,而是在贴近真实硬件的噪声模型下,完整建模一台量子处理器如何执行容错运算。
NVIDIA称,这是迄今对容错量子计算系统所做的最详尽、规模最大的综合模拟,此前没有任何工作以如此完整的细节建模量子处理器。运行平台JUPITER位于德国尤利希研究中心,是欧洲第一台E级(每秒百亿亿次)超算,也是目前欧洲最大的超算系统。
魔法态培育:为何能省下90%的量子比特?
要理解这次突破的分量,先要弄清“噪声”这个量子计算绕不开的难题。量子比特工作在物理规律的极限上,控制它们所需的交互不可避免地引入误差噪声。在这种噪声下做计算,就是所谓“容错量子计算”。
容错计算高度依赖一种叫做“魔法态”(magic state)的特殊量子态,它在运算过程中会被持续消耗,因此必须源源不断地“生产”出来。魔法态生产得够不够高效,直接决定了一台实用量子计算机需要堆多少物理量子比特。
NVIDIA团队这次在真实噪声条件下,完整模拟了魔法态的“培育”(cultivation)过程,并验证了这一当前最先进路线的有效性。官方给出的结论是:采用该方法后,构建有用量子计算机所需的物理量子比特,比传统方法少约90%。黄仁勋对此评价称,有用的量子计算必然是极其复杂的容错系统,而理解它们在大规模下如何运行,是造出来的前提。
从4颗GPU到8192颗GPU的扩展之路
模拟魔法态培育之所以必要,是因为它能让研究者在造出量子硬件之前就评估、改进设计。但这类模拟的内存需求会随量子比特数量呈指数级增长,单靠传统系统根本扛不住。
NVIDIA的做法是分两步走:项目的“练兵场”设在NVIDIA加速量子研究中心(NVAQC),那里的一套GB200 NVL72系统是开发平台。研究者先在上面把测试从4颗GPU一路扩展到数百颗,验证方法正确性和精度随算力扩展的规律,再迁移到JUPITER上铺开至8192颗GPU。
模拟软件栈由NVIDIA cuQuantum提供高度优化的性能与扩展性,并借助CUDA-Q平台的容错逻辑层来表达魔法态电路。这套“先小后大”的工程节奏,最终把原本可能耗时数周的模拟压缩到数天完成,也让团队第一次真正摸透了如何高效调用E级超算的算力。
先模拟、后造机:把实用化路程缩短数年
这次模拟更深远的意义在于,它给整个量子产业提供了一份“噪声影响地图”。在真实硬件噪声下跑通完整流程后,研究者第一次能量化看到误差如何在容错系统中累积、传播,从而在流片和搭建真实量子硬件之前就优化设计,减少对硬件反复试错的依赖。
尤利希超算中心负责人Kristel Michielsen表示,欧洲对JUPITER的投入,让研究者得以追问过去遥不可及的问题;与NVIDIA合作,则把这种能力带进了量子计算领域,帮助科学家在最可能产出实用应用的设计方向上做出更明智的选择。
按照NVIDIA的说法,这类模拟正在为药物发现、金融建模和材料科学等领域的有用量子应用铺平道路。而通往这些应用的时间,有望因此缩短数年。
值得注意的是,这次演示本身就是一个信号:当量子硬件还在为数百个物理量子比特苦苦挣扎时,GPU超算已经成为量子研究不可或缺的“虚拟试验场”。量子处理器与GPU超算并非替代关系,而是协同关系。前者负责未来的算力,后者负责今天把未来的设计算清楚。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序