
GPU与NPU,谁更适合AI?
人工智能早已不局限于云端服务器与实验室。AI从数据中心走向手机、PC、智能家居与汽车,GPU与NPU的对比也随之成为核心议题。GPU长期是高端AI算力的主力,其并行架构擅长海量数据处理,天然适配模型训练;而AI应用向终端下沉,催生了NPU这类面向AI任务的专用硬件。终端设备基数庞大,意味着端侧AI是增量市场,与云端训练市场并行扩张。
GPU最初为游戏与视觉渲染而生,却凭借并行架构成为AI训练的事实标准。CPU按顺序执行任务,GPU可同时发起大量运算,灵活性更强,适合深度学习训练、大规模神经网络运算与海量数据集处理。正因如此,GPU成为现代AI硬件的核心:算力强劲、支撑数据中心级负载,是大语言模型与计算机视觉系统的主要训练载体,大规模训练场景中仍难以替代。英伟达的优势不止于硬件,其CUDA软件栈沉淀十余年,让训练框架与开发者习惯深度绑定,构成了先发者壁垒。
NPU是专为执行AI任务设计的处理单元。相比兼顾通用计算的GPU,NPU运行神经网络模型的能效更高,能在低功耗下完成人脸识别、语音助手、实时翻译、AI影像增强、背景虚化与端侧实时推理。对需要即时响应的设备而言,NPU降低了云端依赖,是端侧AI的关键组件。随着端侧大模型普及,NPU正在从"辅助加速器"升级为SoC中的关键算力单元。
GPU vs NPU:核心差异
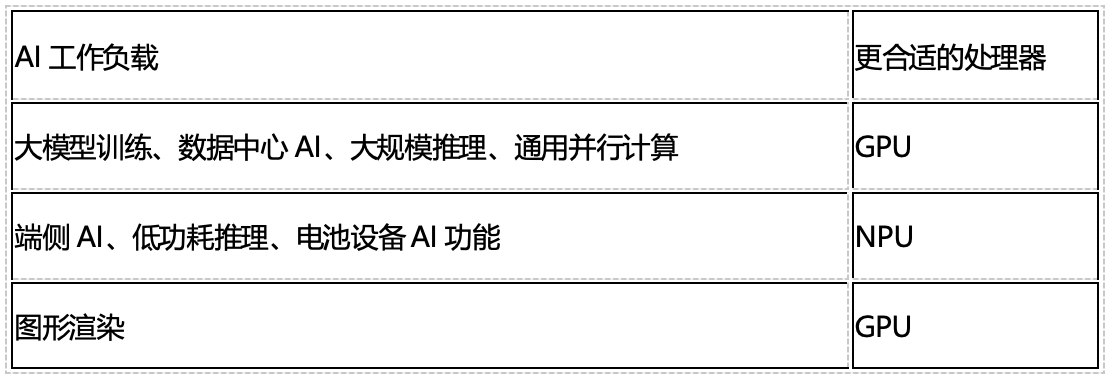
差异本质是架构取向:GPU追求高性能与通用性,NPU追求能效与AI专用算力。GPU在数据中心训练模型,NPU在终端完成实时AI任务。功耗是最直观的分野——GPU功耗远高于NPU,后者更适合手机等电池供电设备。简言之:GPU是高性能、灵活的AI算力;NPU是专用、低功耗的AI算力。负载决定选择:
过去AI计算多集中于云端,依赖网络与数据中心。NPU让数据在本地处理成为可能:手机即时完成人脸识别、语音助手离线应答、相机实时优化画面。本地处理还降低了数据传输成本与隐私风险,这是端侧AI被看好的另一重动因。这一趋势推动NPU进入消费电子,并逐步向中端机型渗透。
厂商路线分化清晰,苹果自A11仿生芯片起内置神经网络引擎,高通将Hexagon AI引擎集成进骁龙平台,AMD推出XDNA架构NPU,英特尔在酷睿Ultra中引入NPU,华为在麒麟SoC与昇腾AI芯片中同样强化了NPU能力。GPU一侧,业内普遍认为英伟达凭借CUDA生态构建了难以撼动的软件护城河;NPU软件栈则仍显碎片化,ONNX、OpenVINO、TensorRT等中间层正在弥合差距。此外,先进制程与HBM等存储资源的分配,使AI芯片的供给与成本深度绑定晶圆厂产能。从产业格局看,AI芯片的竞争正从单点算力转向"云-边-端"协同:云端训练由GPU主导,端侧推理由NPU承接,两者通过模型压缩与量化技术衔接,分工而非替代成为主旋律。
未来主流不会是单一处理器,而是CPU、GPU、NPU协同的异构方案:CPU处理通用任务,GPU承载图形与重负载并行计算,NPU承接AI运算。以笔记本为例,CPU运行常规应用,GPU处理图形,NPU负责背景虚化、语音识别等AI功能。手机SoC同样遵循这一思路,旗舰平台普遍在CPU、GPU之外集成独立NPU模块。混合架构可在性能、能效与续航间取得更优平衡,已成为消费级SoC的设计共识。
专用AI芯片研发成本高、技术门槛高,厂商需在性能、制造成本与功耗之间权衡;软件生态亦未成熟,不同硬件缺乏统一标准,开发者难以充分释放算力。NPU的能效优势还依赖专用化设计,专用程度越高、适用范围越窄,厂商需要在通用性与效率之间取舍。这也意味着,未来的竞争不只是硬件参数之争,更是生态与工具链之争。
AI算力需求持续增长,NPU将向更强算力、更低功耗演进,面向可穿戴与物联网的能效型AI芯片会增多,软硬件协同也将更加紧密。大模型向端侧部署的尝试,正在抬高终端NPU的算力与内存需求,反过来推动芯片设计持续迭代。GPU与NPU并非替代关系,而是分工互补:GPU仍是大规模AI训练的首选,NPU让实时AI功能在终端流畅运行。二者与CPU协同,共同构成AI计算的基础设施,推动算力更快、更省电、更易获取。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序