基于CFET器件路线图迭代:新型集成模块与标准单元结构
半导体行业正经历重大架构变革,在3nm及更先进逻辑节点中,环绕栅(GAA)纳米片晶体管正在取代FinFET。GAA纳米片晶体管技术可一直延伸至A10逻辑代,能够实现5.5轨(T)标准单元,轨是衡量标准单元高度的指标。
受AI革命驱动,应用需求日趋多元,A7节点的技术方案也越来越丰富。根据imec最新路线图,其中一种思路是基于imec的CMOS 2.0缩放范式进行系统设计。CMOS 2.0将片上系统(SoC)拆分为多个异构功能层,每一层选用最适配的工艺进行优化,并通过3D互连技术重新互联。另一些场景下,GAA纳米片技术会被推向缩放极限,可采用正面或背面供电。行业也有可能转向互补场效应晶体管(CFET)器件架构。CFET将pMOS与nMOS晶体管上下堆叠,可把标准单元进一步缩小至3轨,从而将传统CMOS逻辑路线至少延伸到A3工艺节点。
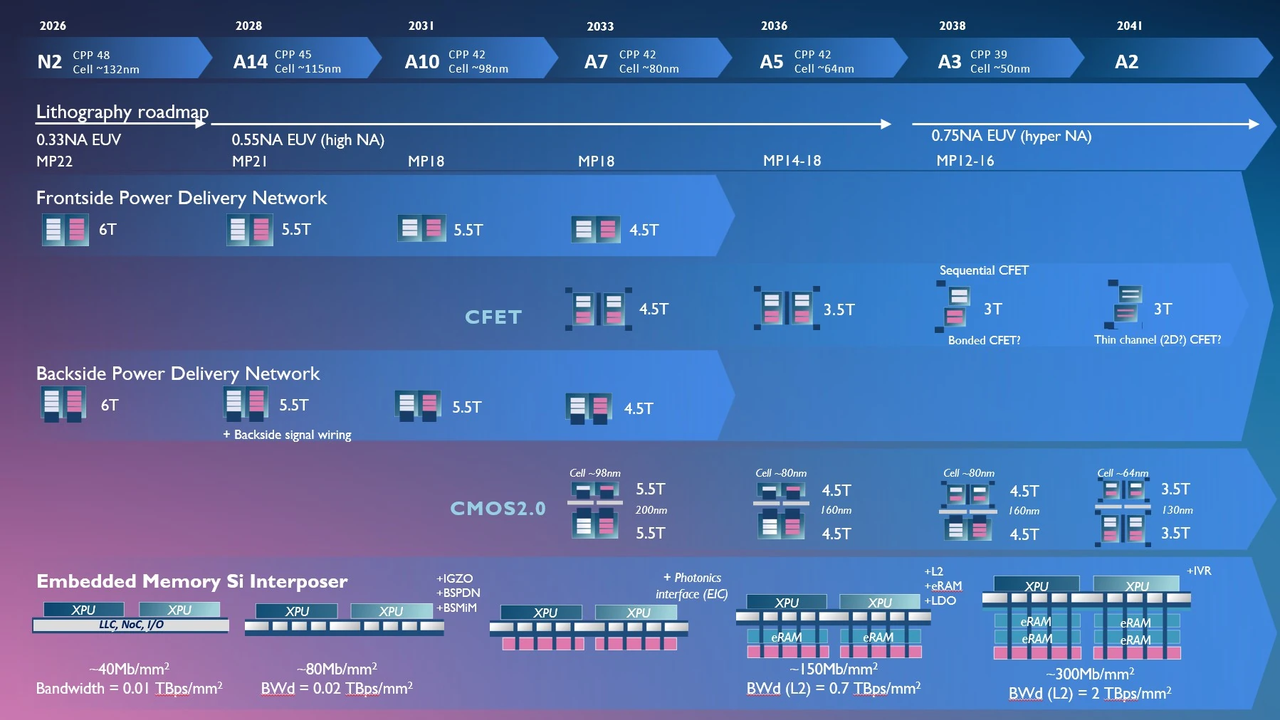
图1:imec逻辑技术路线图
imec及其产业合作伙伴正在推动基于CFET器件的量产落地。近年来,团队搭建了关键集成方案的技术基础,分为单片CFET(mCFET)与顺序CFET(sCFET)两大类。
两种方案都先垂直堆叠硅 / 硅锗层,再在其上制备nFET与pFET。mCFET采用共用上下栅极的垂直器件结构,整套图形化与加工工序一次性完成。在高深宽比器件结构周边与内部进行材料的图形化、沉积与选择性去除,需要投入大量模块开发工作。与之相反,sCFET使用独立掩膜,分别对上层器件与下层器件做图形化。相比mCFET,sCFET单步工艺更简单,但部分关键工序需要做两遍,分别用于上层和下层器件。sCFET还需要两次晶圆翻转,会造成晶圆形变,给上下层器件互连的精准对准带来挑战。在对准精度取得进一步突破前,业界普遍认为mCFET是最快实现产业化的方案。
CFET集成工艺的进展,同步搭配设计 - 工艺协同优化(DTCO)研究,从电路层面评估CFET器件架构。这类研究旨在找到具备可扩展性的标准单元结构与性能增强方案,在功耗、性能、面积与成本之间取得最优权衡。
sCFET全新架构:分栅器件架构放大CFET缩放潜力
早期DTCO研究已经验证CFET技术在后续逻辑节点中的缩放潜力,这是半导体行业采用新器件架构的前提。例如对于mCFET,imec此前确定双排(DR)CFET架构,是将mCFET集成进A7标准单元的最优方案。双排CFET标准单元包含两行堆叠器件,中间共用垂直信号通孔,单元边界设置电源墙(见图2)。后续团队解决了版图利用率低的问题,推出优化版双排CFET:半高双排(hDR)架构。在2025年IEDM会议上,团队引入混合沟道等额外缩放增强技术,支撑面向A3节点的激进面积缩减目标。
共栅与分栅器件:单器件架构同时实现两种方案的难题
mCFET的制备流程天然支持共栅器件:nFET与pFET的栅极在结构上相互连通。该方案适用于90%~95% 的基础逻辑门,例如实现非逻辑的反相器。但触发器、多路选择器等其他逻辑电路,需要独立控制nFET与pFET的金属栅极。一种解决思路是弃用堆叠CFET器件中的某一种极性(例如仅使用nFET,去掉pFET)。该方法虽然解决栅控问题,却无法充分发挥n/pFET堆叠带来的面积优势。
sCFET器件架构的上层、下层器件分开图形化,能更自然地实现分栅器件。但传统sCFET架构存在相反的问题:需要额外工艺模块,为需要共栅的电路实现栅极互连。
双翻转sCFET架构:兼顾两种模式,保持面积效率
在2026年VLSI会议上,imec提出双翻转sCFET架构,可同时支持分栅、共栅器件,且不会损失面积利用率。
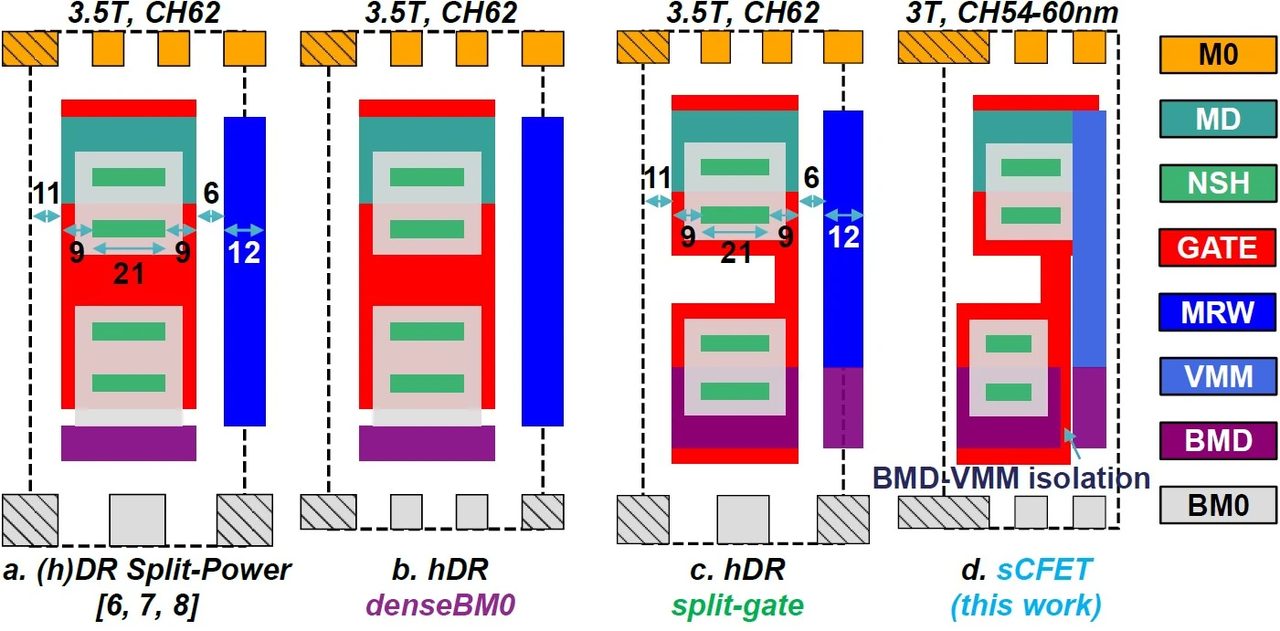
图2:截面示意图 (a) 双排mCFET(DR);(b) 高密度背面金属0轨(BM0)的半高双排(hDR);(c) 带分栅的hDR;(d) 带分栅与高密度BM0的sCFET(2026 VLSI发布)。 (CH = 标准单元高度;NSH = 纳米片沟道;MRW = 共用信号墙;VMM = 可绕过下层器件的通孔;MD = 金属 - 扩散层)
团队基于AND、OR、反相器等电路搭建多套CFET单元库,评估新架构在面积效率与布线能力上的表现。新双翻转sCFET架构整体单元库效率(h)高达98%,相比双排(DR)、半高双排(hDR)mCFET架构,版图面积利用率最优。搭配高密度背面金属0(BM0)布线后,该架构可实现3轨标准单元,满足imec最新技术路线中A3、A2逻辑节点的需求。
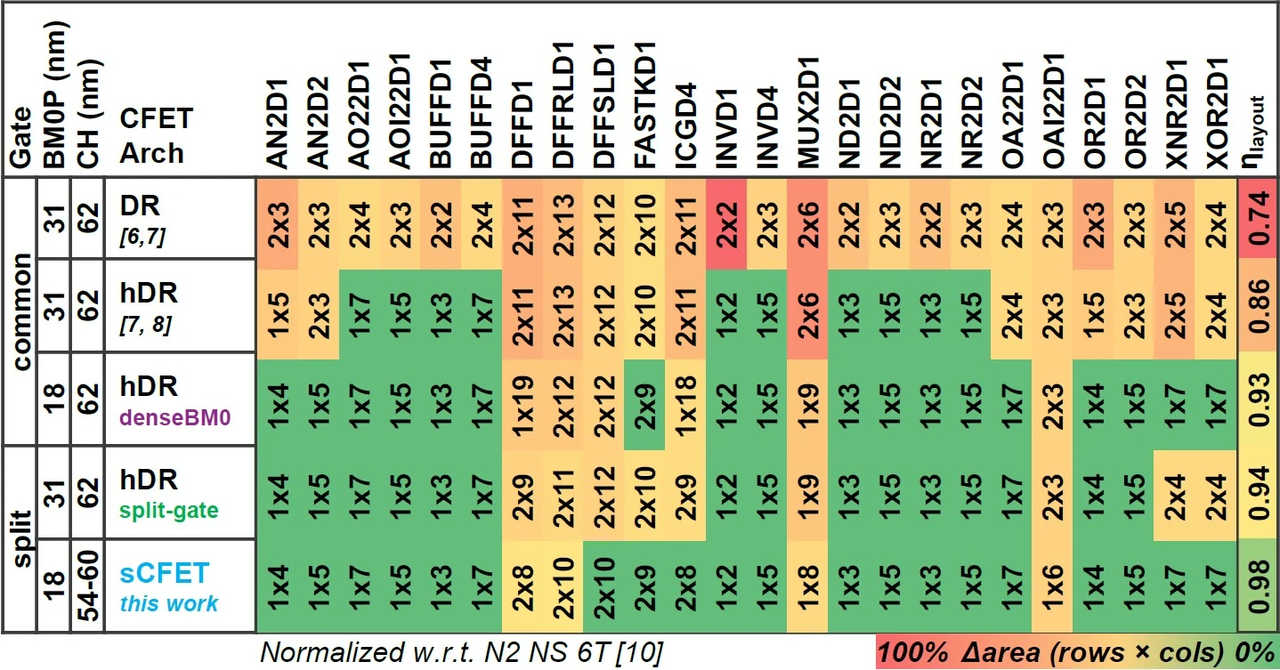
图3:不同CFET架构(双排DR、半高双排hDR、带高密度背面金属0布线hDR/dense BM0、双翻转sCFET)的CFET单元库面积拆解。sCFET大幅优化单元库,整体版图效率达到98%(2026 VLSI发布)。
双翻转sCFET工艺起始于键合堆叠结构,上层与下层器件之间内置介质隔离层eMDI。第一步从正面图形化上层器件,上栅在替换金属栅模块中完成部分制备。晶圆翻转并减薄后,从背面图形化下层器件。之后可按需制备上下栅之间的通孔,用于共栅场景。完成第二次晶圆翻转,再完成上下两层器件的全部加工。
还可引入混合沟道进一步释放缩放潜力,分别针对nFET与pFET做优化。例如上下层器件采用不同沟道取向,或是非对称纳米片宽度的CFET器件。这能够进一步优化功耗、性能、面积指标,提升设计灵活性。
5T+1 CFET SRAM存储单元:sCFET分栅架构延续SRAM缩放路线
静态随机存储器(SRAM)一直是片上高速缓存的主力,作为DRAM与XPU之间的高速存储接口。传统SRAM存储单元包含6颗晶体管:4个nFET与2个pFET(也可采用2个nFET、4个pFET)。其中2个nFET与2个pFET(图5、6中PUx、PDx)配对形成两个交叉耦合反相器,用于存储1比特数据。剩余nFET作为传输门(PG),连接位线(BL)与字线(WL),在读写过程中控制数据流。
SRAM密度危机:CFET能否破局?
和逻辑器件一样,SRAM存储密度提升依赖存储单元尺寸微缩与器件架构创新。但自7nm节点起,SRAM单元缩放速度落后于逻辑CMOS器件。这种缩放能力的失衡给芯片设计者带来巨大挑战。即便换成基于GAA纳米片的6T SRAM单元,也无法实现预期的功耗、性能与面积收益。基于CFET的6T SRAM有望初步缓解该困境,将部分nFET与pFET(PUx、PDx)堆叠,能够显著提升SRAM单元密度。
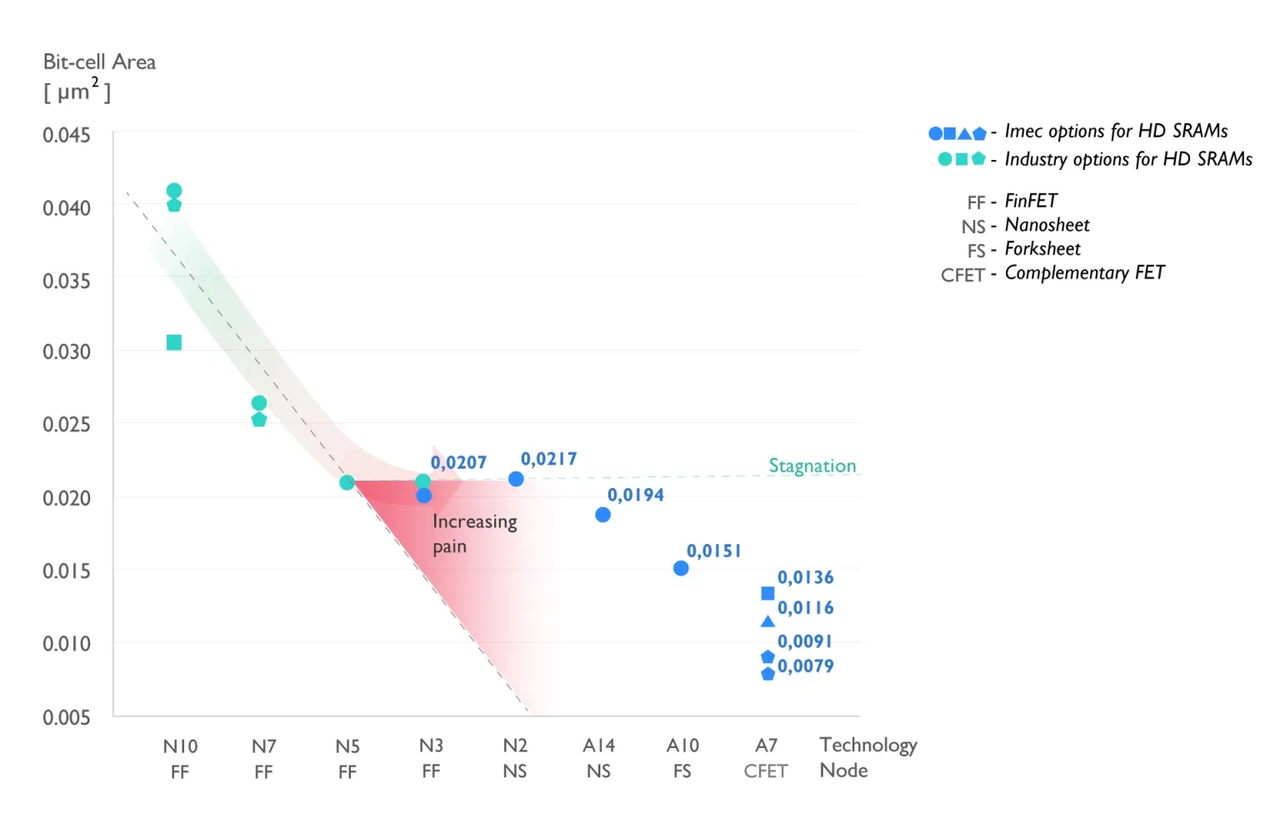
图4:SRAM密度危机。蓝色标记为imec高密度SRAM方案,包含单排、双排、优化双排以及全新5T+1架构(2026 VLSI发布)。
但即便进入CFET SRAM时代,面积缩减依然面临瓶颈:6T SRAM单元无法和CFET架构高效匹配。两个反相器可以采用n/p堆叠器件架构(PUx、PDx),但作为一对传输门(PG)的两个nFET,会造成CFET堆叠结构中上方两颗p型晶体管闲置。结果就是CFET原生的垂直密度优势,无法完整转化为6T SRAM单元的面积缩减。业界研究过仅含单个传输门的5T SRAM单元作为面积优化方案,但写入能力与噪声问题限制其落地。
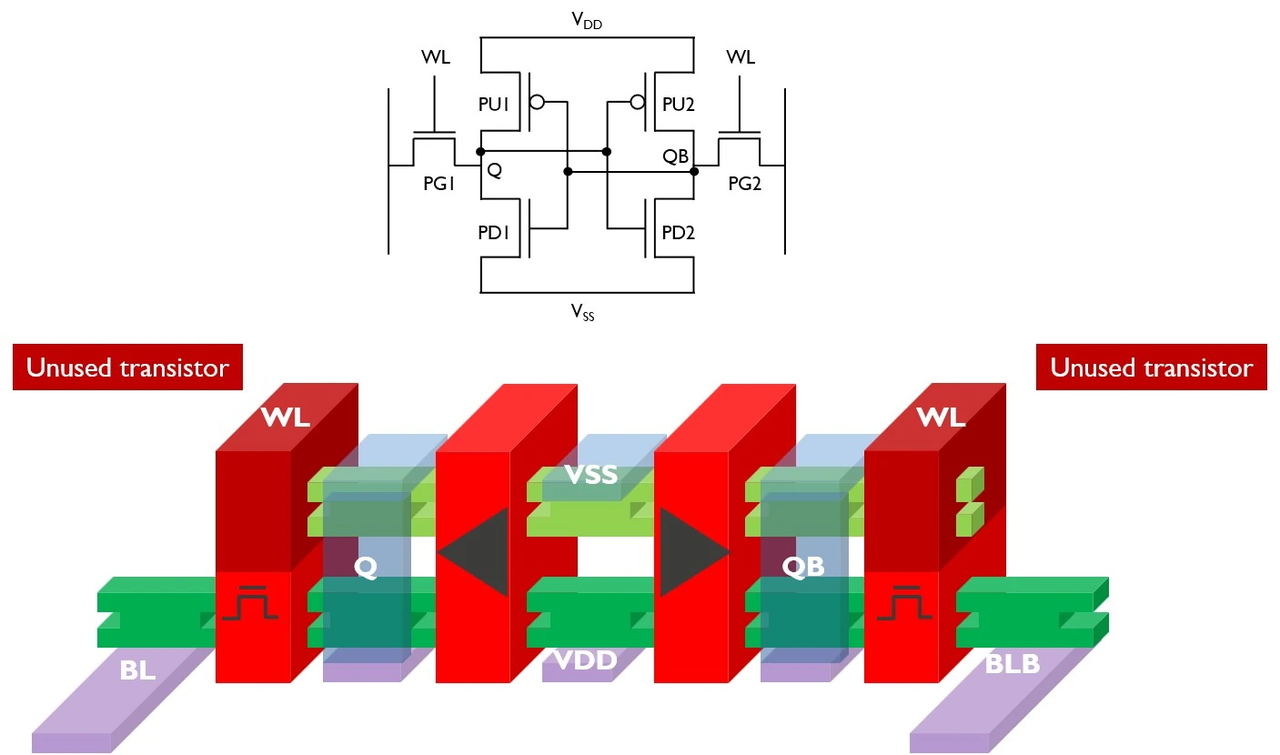
图5:传统6T SRAM原理图,难以适配CFET架构(2026 VLSI发布)。 (WL = 字线;BL、BLB = 位线;PUx、PDx构成交叉耦合反相器,存储1比特;VSS、VDD为电源轨)
极具潜力的5T+1 CFET SRAM架构:依托sCFET分栅器件实现
imec全新sCFET分栅器件架构,为SRAM密度持续微缩打开空间,相关成果在2026 VLSI发布。在创新5T+1架构中,两个独立传输门晶体管(PG)替换为一颗由nFET与pFET配对构成的CFET传输门(TG)。该传输门需要独立控制n栅与p栅,可通过imec全新sCFET分栅器件实现。由此能够实现类似5T结构的SRAM单元(带sCFET传输门的单端SRAM单元),保持5T单元的面积。相比传统5T方案,采用传输门作为访问器件还提升了写入能力。
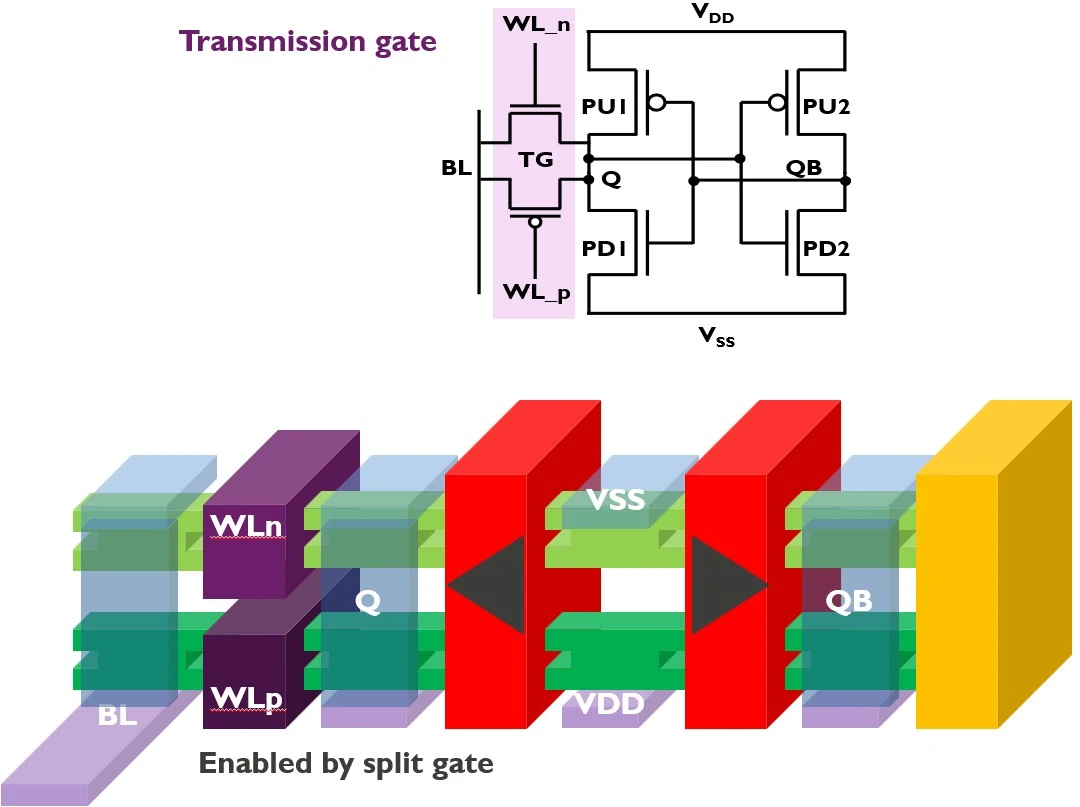
图6:带传输门的5T+1 CFET SRAM原理图(2026 VLSI发布)。 (BL = 位线;WLn、WLp分别连接传输门TG中nFET、pFET的字线;VSS、VDD为电源轨)
通过在存储阵列层面优化版图与布线能力,可进一步改善SRAM工作性能。imec DTCO研究显示,采用这套创新5T+1结构,存储单元面积相比传统6T CFET SRAM缩小12.5%,写入速度提升7%~15%。5T+1 CFET SRAM单元因此具备很大吸引力,可将SRAM缩放路线延续至A7及以后节点。
不止标准单元:提升BEOL布线能力,支撑CFET缩放路线
在多项DTCO研究中,imec借助创新标准单元结构与缩放增强技术,证明CFET器件架构可在后续逻辑节点持续微缩。但imec在2026 VLSI上发布的一项新DTCO研究指出:迈入埃米时代后,标准单元层面的面积优势,很容易被后端金属互连(BEOL)的缩放问题抵消。简单来说,各个CFET标准单元之间的互连布线会越来越困难。
理想等比例缩放场景下,所有参数同步缩小,各节点布线能力保持不变。但从2nm节点开始,接触多晶硅节距(CPP,由栅长与源漏接触长度共同决定)、金属1节距等基础规则的缩放放缓,造成晶圆正面布线拥塞,影响性能、功耗与面积。同时,激进的标准单元缩小,会降低输入输出引脚的可访问性。
提高齿轮比:面向CFET埃米节点,优化BEOL布线能力
好在有多种手段改善BEOL布线能力,其中之一是提升齿轮比(gear ratio),即CPP与金属1节距的比值。2nm处理器设计中,齿轮比通常约1:1。imec在2026 VLSI上通过DTCO研究证明,将A7 CFET设计的齿轮比提升至2:1,可在不牺牲功耗与性能的前提下,同时改善引脚可访问性与面积利用率。实际落地中,这会推动M1金属采用更小节距,需要高NA EUV单重曝光等更先进光刻方案来制造。
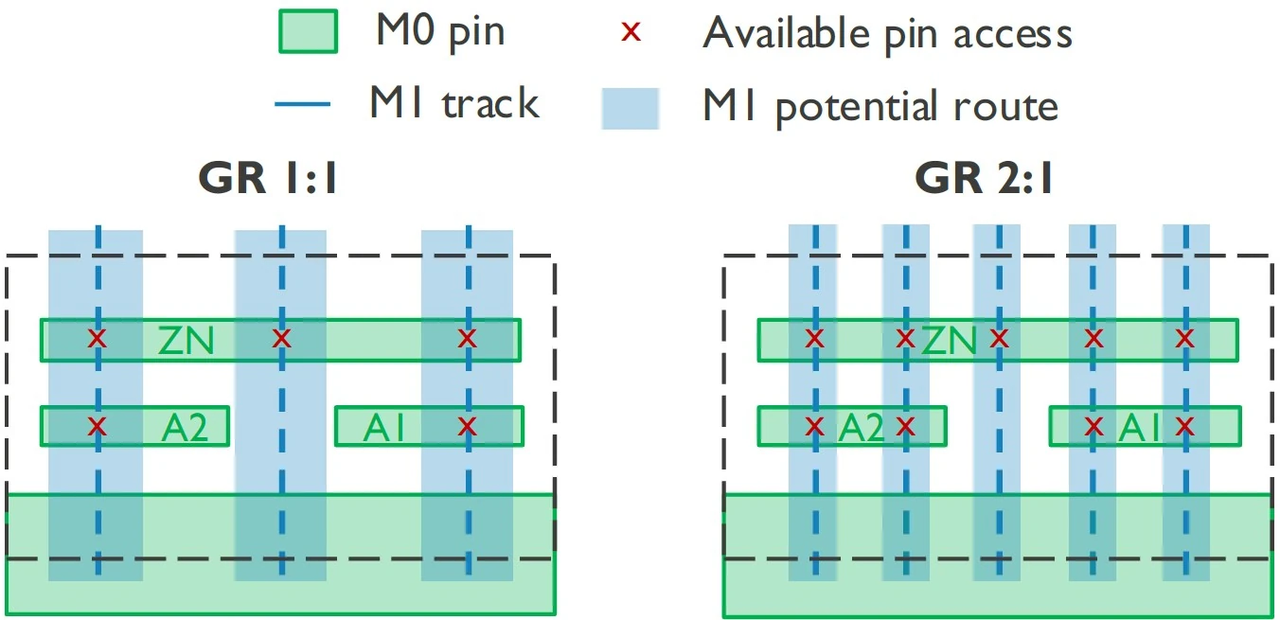
图7:A7节点ND2D1单元M1布线示意图,对比齿轮比GR=1:1与GR=2:1,GR=2:1下引脚可访问性得到改善(2026 VLSI发布)。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。




联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)
半导纵横公众号
半导纵横小程序