
IDC预测:2031年中国活跃智能体将达3.5亿
2026年以来,主流数据库厂商围绕AI的产品与战略发布明显提速。海外Oracle持续迭代Agentic AI增强的数据库,谷歌云发布数据库智能体工具;国内OceanBase、腾讯云、阿里云、华为云等也相继推出面向AI负载的新版本。一时间,“AI原生”成为了行业最热门的标签。
这些密集发布共同指向了一个变化:数据库厂商不再只回答“数据库能否支持AI”,而是开始回答“数据库能为AI承担多少数据准备和持续服务工作”。
IDC认为,这轮竞争的关键不只是增加多少AI功能,而是能否将企业数据转化为AI可持续使用、可治理、成本可控的业务上下文。从功能叠加走向可持续的数据供给,是当前最值得关注的产业变化。
推动数据库迈向AI原生时代
厂商密集发布的背后,是需求侧正在发生的结构性变化。当AI从演示走向生产,企业面对的不再是“要不要用AI”的问题,而是“AI能不能持续、稳定、成本可控地用上企业数据”的问题。
数据规模的膨胀是最直观的挑战。IDC调研显示,2025年企业新生成的数据资产中约90%为非结构化数据,但大量数据散落在各类存储系统、业务系统之中,多模态数据相互割裂,企业手握数据“富矿”,却缺少将数据转化为AI可用燃料的冶炼能力。
更紧迫的是时间窗口。《IDC FutureScape:全球Agentic AI 2026年预测——中国启示》指出,到2027年,未优先构建高质量AI就绪数据的企业,在扩展生成式AI和Agentic AI解决方案时将面临显著挑战,导致生产力下降15%。
传统架构的三大困局
造成企业AI落地困局的本质,是传统架构围绕结构化数据构建,难以应对海量非结构化多模态数据的处理需求。
第一是数据割裂。数据分散在多系统带来副本冗余、版本不一致,极易引发AI输出失真。当同一个客户信息在CRM、ERP和客服系统中存在三个不同版本时,AI该信哪个?
第二是访问主体变了。数据访问主体正在从人类用户向AI Agent转变。传统数据库缺少适配机器高频访问的安全、隔离与状态管理能力。Agent需要的是毫秒级的上下文获取,而不是人工触发的查询。
第三是治理缺失。传统治理体系无法覆盖向量、多模态数据,缺少将原始业务数据加工为AI可用上下文的完整链路。数据能存进去,却“喂”不给AI,等于白存。
为此,企业需要数据库具备多模态混合检索、Agent运行支撑、AI链路治理,以及成熟的企业级能力,支撑AI走向生产落地。这一产业现实,也让AI原生数据库的价值被推到台前。
向量检索只是入场券
值得警惕的是,给数据库增加一个向量检索能力,或者在管理控制台中接入一个对话助手,并不足以说明整个系统已经完成了AI原生转型。
判断“原生”程度,更有价值的观察标准是:当数据发生变化、模型需要替换、权限需要调整、负载出现波动时,这些能力能否在统一的管理机制下持续运行,还是仍需开发者在多个系统之间反复维护连接与同步关系。
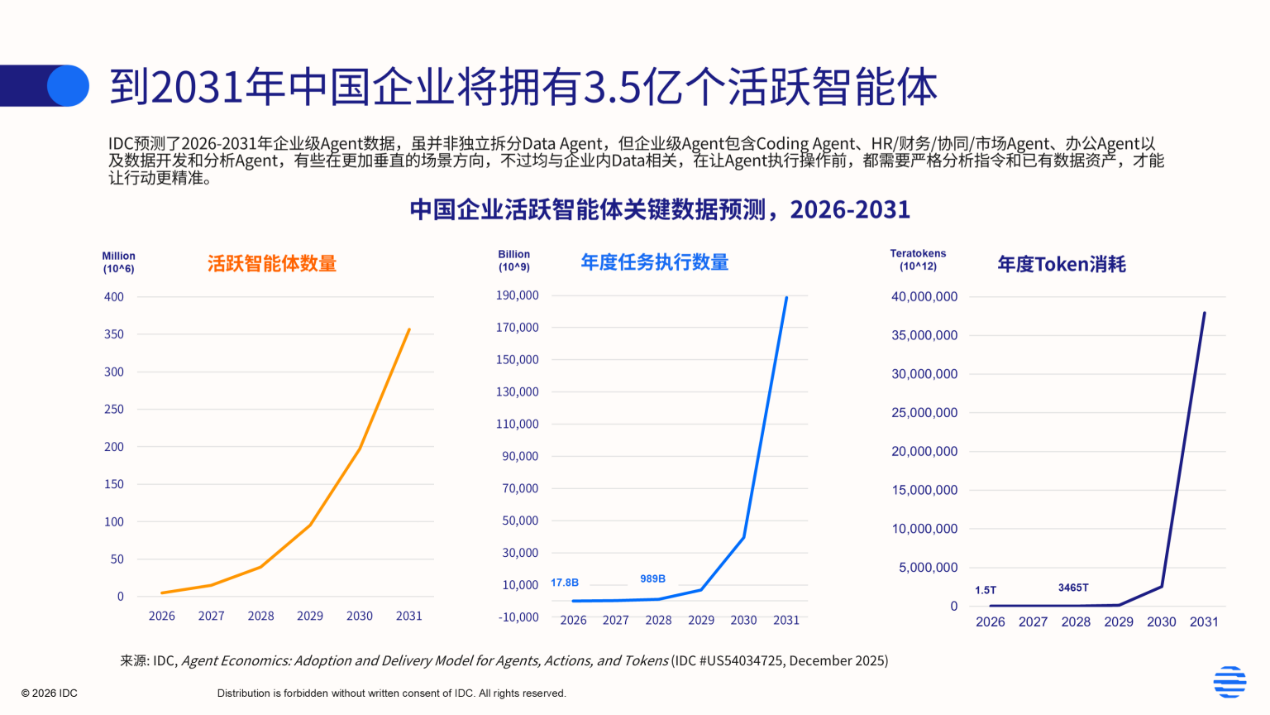
IDC预测,到2031年中国企业将拥有3.5亿个活跃智能体。当数据库服务对象拓展至持续执行任务的智能体时,数据访问需求不再局限于单次查询。Agent的长周期任务会反复读取数据、留存中间状态、调用工具并迭代执行逻辑,记忆与状态管理因此至关重要。AI与Agent并没有让数据库传统能力失去价值,事务一致性、资源隔离、故障恢复和可观测性依然重要,需与新的检索、记忆能力一起接受检验。
与此同时,“一体化数据管理底座”趋势愈发明显。厂商越来越少只发布孤立的检索功能,而是提供覆盖数据接入、处理、治理和应用服务的组合。但不能将“一体化”简单理解为“一个数据库替代所有系统”。对于企业而言,更重要的是减少重复数据搬运、矛盾的业务定义和分散的权限管理,而非追求产品数量最少。
结语
从“功能叠加”走向“可持续的数据供给”,是当前AI原生数据库发展最值得关注的产业变化。这轮竞争最终的胜负手,不在于谁先把向量检索塞进数据库,而在于谁能把企业数据转化为AI持续可用、可治理、成本可控的业务上下文。
对于企业而言,AI的竞争焦点正在离开大模型本身的能力演示,转向如何让存量数据真正服务于生产级AI业务。而数据库,作为企业数据的主要承载者,自然被推到了这轮变化的前台。当90%的非结构化数据还在沉睡,谁先唤醒它们,谁就拿到了AI落地的下一张入场券。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序