
PieceMakers:押注HBM之外的推理内存
近日DRAM 设计公司 PieceMakers 在中国台湾兴柜市场挂牌,参考价新台币 740 元。以约 6040 万股流通股计算,这一参考价对应公司估值约新台币 447 亿元,约合 14 亿美元。
PieceMakers 于 2006 年 1 月在中国台湾新竹成立,董事长 Joseph Ting 与总裁 Lee Hsiao-wen 掌舵。历史上,这家公司通过位于中国、日本、法国、土耳其和以色列的代理商,设计标准 SDR 与 DDR DRAM 以及已知良品裸片(KGD)产品。
眼下它正从直接销售产品转向定制设计服务,以一次性工程费用(NRE)计费,并计划自 2027 年起进一步转向 IP 授权、版税与交钥匙量产。这一路线在 9 月 7 日的简报会上对外说明。收入结构的变化比路线图更直观,AI 定制设计部门收入已从 2024 年的约 4% 升至 2026 年上半年的近 40%。
支撑这块增长的是两款产品。一款是 HBLL,即高带宽低延迟 RAM,2D 裸片形态,标称 144 GB/s,2016 年面向英特尔的 HPC 产品线流片,2017 年在 ISSCC 发表。另一款是 HiBaLL,3D 堆叠版本,公司称标称带宽超过 1 TB/s。
客户一侧,公司向媒体描述的对象是云端 AI 推理加速器开发商、半导体厂商以及北美客户,部分项目处于设计与验证阶段,均未点名。高通 CEO 克里斯蒂亚诺·阿蒙 6 月在 Computex 主题演讲的背景中,把 PieceMakers 列入了生态合作伙伴名单,双方都没有进一步界定这段关系。
需要注意的是利润来源,目前这家公司的收入以设计费为主,而不是芯片,2026 年上半年 AI 定制设计业务已占营收约 40%。董事长 Joseph Ting 表示,首个量产客户项目最早要到 2027 年才会贡献业绩。这是一门版税前的一次性工程费用生意,与存储器厂商的模型并不相同。
南亚的路线选择,定制加边缘而非 HBM3E
PieceMakers 是南亚 2024 年所定人工智能内存战略的前半段,后半段落在边缘侧。
2025 年 8 月 7 日,南亚宣布与总部位于新竹的芯片设计公司钰创科技成立合资公司,资本额新台币 5 亿元,持股比例 80 比 20。这家合资公司的定位是为边缘 AI 设备设计定制高带宽内存,而不是为数据中心加速器。南亚总裁李培瑛在 2025 年早些时候曾表示,公司不会参与 HBM3 或 HBM3E 的竞争。
这条战略的两个半段在封装上都依赖台塑集团旗下的测试与组装子公司福懋科技,后者正在建设两者所需的硅通孔(TSV)与裸片堆叠工艺。
推动南亚走上这条路的背景是另一件事。DRAM 价格的飙升让大宗商品内存成为南亚真正的主营业务,PieceMakers 这笔投入不大的附带押注因此变成了意外收获。南亚趁势减持,姿态更接近一名投资者,而不是正在自建内存栈的母公司。
推理侧出现的两个版本
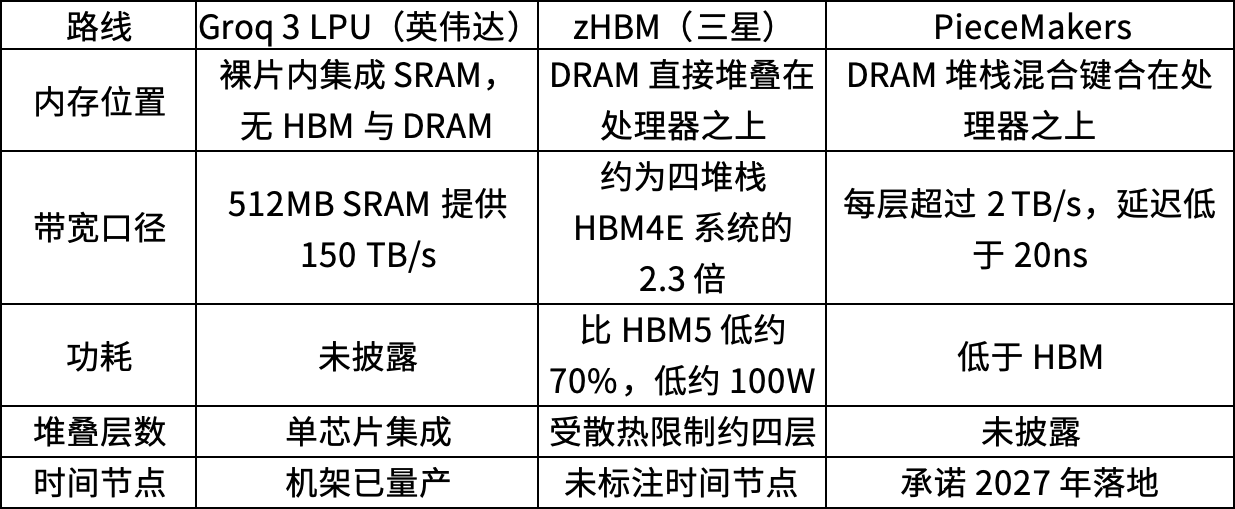
英伟达的方案是彻底不用 DRAM。 英伟达于 2025 年 12 月 24 日与 Groq 达成 200 亿美元的授权与人才交易。今年早些时候在圣何塞举行的 GTC 上,由此诞生的首款芯片 Groq 3 LPU发布,这是一款基于 SRAM 的推理芯片,裸片上没有 HBM 也没有 DRAM,而是在裸片内集成 512MB SRAM,提供 150 TB/s 的带宽,对比每颗 Rubin GPU 上 288GB HBM4 的 22 TB/s。它是一款仅解码的协处理器,由 Rubin 负责提示词预填充,英伟达路线图上原有的 Rubin CPX 因此被挤出。
在 Hot Chips 2026 上,英伟达的 Igor Arsovski(Groq 前首席架构师)表示该机架已量产,并公布了首个第三方基准测试。在 310 亿参数模型、100K 上下文的单请求测试中,吞吐约为竞品中最快的公开端点的四倍,即每秒 3431 个 token。这一单请求测试与其对标的共享端点并不直接可比。代价在容量一侧,按每芯片 512MB 计,一个搭载 256 颗 LPU 的机架只能容纳 128GB,而基准测试所需的权重在 FP8 精度下就要占用 62 颗芯片的容量。英伟达为解码速度接受了这一取舍,也印证了 Lee Hsiao-wen 的判断,这家市场领头羊最新的推理产品中不含任何 HBM。
三星的方案是把 DRAM 直接堆到处理器上。 同在 Hot Chips 上,三星的 Sangwook Han 给出了一份三阶段 HBM 路线图,终点是 zHBM,即 DRAM 直接堆叠在处理器之上,而不是放在中介层旁侧。三星预计 zHBM 的 I/O 功耗比 HBM5 低约 70%,带宽约为四堆栈 HBM4E 系统的 2.3 倍;由于散热限制,堆叠层数被限制在四层左右,功耗低约 100W。实现这一路线需要晶圆对晶圆的混合铜键合,以及 DRAM 与 SoC 团队之间的紧密协同设计。SK 海力士封装工程副总裁 Jaesik Lee 在 8 月 23 日表示,混合键合还无法赶上 HBM4E,HBM5 是最早的时间点。Counterpoint Research 则预计,这项技术要到 2029 至 2030 年前后才在 HBM 上实现规模化量产。
PieceMakers 想做的是第三种。 它不采用 GPU 加 HBM 的 2.5D 布局,而是以晶圆对晶圆的方式,用混合键合替代微凸点,把 DRAM 堆栈直接键合到处理器上。更细的间距能容纳多得多的互连,带宽随之提升;更短的路径则同时降低延迟与功耗。公司数据称,其晶圆对晶圆产品每层超过 2 TB/s,延迟低于 20ns,目标是在成本与功耗都低于 HBM 的前提下,获得比 SRAM 更大的容量。Ting 补充说,PieceMakers 本身不做 TSV 也不做混合键合,这部分由客户的逻辑晶圆代工厂完成。这项定制服务承诺 2027 年落地,对手是三星尚未标注时间节点的路线图终点,以及 SK 海力士给出的 HBM5 最早时间表。
良率才是真正的产品
Lee Hsiao-wen 表示,良率是晶圆对晶圆量产的最大障碍。修复架构必须预先设计进去,并要在键合前、键合后以及逻辑集成后分别进行测试。他举的例子是每层 80% 的良率,这样四层堆叠后只剩约 41%,八层则仅有 17%。
这也解释了公司在出售带宽的同时,为什么也大量销售修复与已知良品裸片 IP。IP 加版税的模式之所以契合这条战略,原因同样在这里,良率 IP 可以在不同客户之间移植,一个带宽数字却不能。
对 PieceMakers 而言,在出现首个具名客户之前,AI 收入仍将主要是一次性工程费用,首个量产项目预计最早 2027 年出现。Ting 表示,南亚将于 10 月下旬公布 2026 年第三季度业绩,届时可以评估 PieceMakers 的收益情况,并披露更多财务信息。
SK 海力士的混合键合时间表是当前的行业基准,不过其 16 层与 20 层的内存堆栈,与逻辑晶圆上寥寥数层 DRAM 属于不同的问题。高通可能也会更正式地说明其与 PieceMakers 的关系。
按目前的路径推演,PieceMakers 最终很可能成为一家 IP 授权商,拥有少量加速器客户,并经南亚与福懋科技实现交钥匙量产。技术风险由代工厂与客户承担,这正是设计费模式得以成立的前提。市场预计公司将受益于 2027 至 2028 年的放量,这一时间晚于 Ting 所说的 2027 年。如果最大的 HBM 厂商都要等到 HBM5 之后才愿意以这种方式键合自家内存,那么 PieceMakers 自己给出的 2027 年,就是它必须兑现的那个日期。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序