
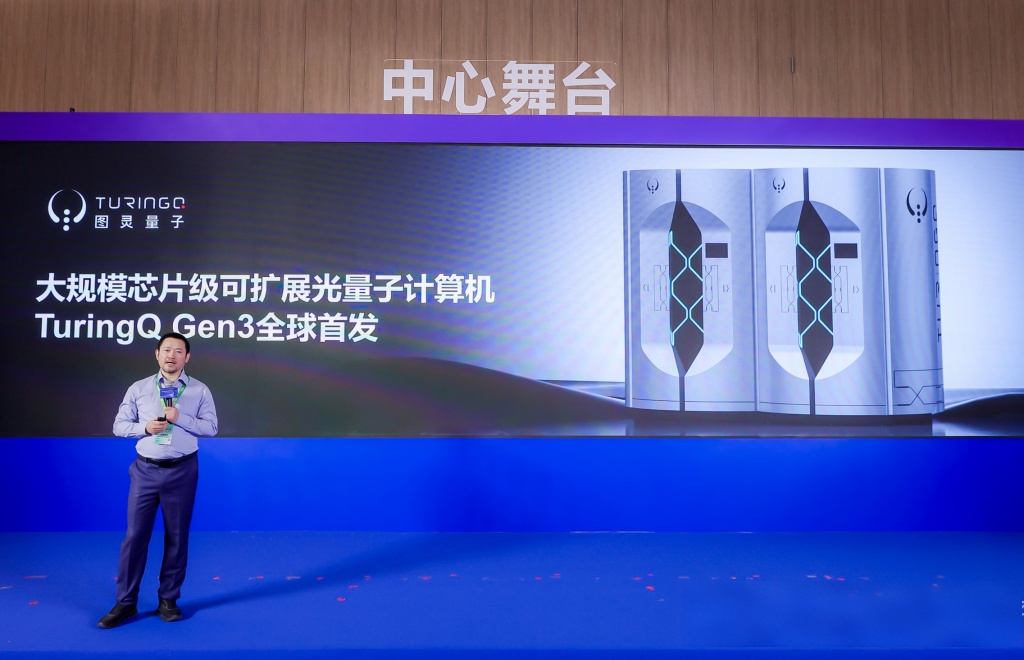
图灵量子全球首发第三代光量子计算机TuringQ Gen3
近日,图灵量子正式发布TuringQ Gen3大规模芯片级可扩展光量子计算机,这是全球首发的第三代光量子计算机,实现单芯片万光子级、百万模式数的算力规模,标志着我国光量子计算从量子优越性验证阶段,向着规模化可编程计算与产业落地迈出关键一步。该系统依托薄膜铌酸锂光量子芯片构建全芯片化、模块化整机方案,攻克损耗控制这一工程化核心难题,并且探索高斯玻色采样在世界模型等前沿人工智能任务中的应用潜力。
光量子计算具备室温运行、高并行度等天然优势,但长期面临系统规模扩展与传输损耗之间难以平衡的工程矛盾。传统思路单纯提升光子数量与模式数量,却忽略真实系统损耗带来的有效性问题。2024年,芝加哥大学蒋良团队在《Nature Physics》发表研究,明确了损耗约束下高斯玻色采样量子优越性的严格判定边界,也指出此前国内外多项量子优越性演示成果,在该标准下并不成立。这一结论重塑行业评判标尺:真正有效的量子优越性,不能只看光子、模式数量指标,必须在真实系统损耗条件下,让有效计算规模超越经典高性能算法的模拟极限。
面对这一严苛标准,图灵量子团队以芯片工程化为核心开展长期攻关,推出TuringQ Gen3整机系统。该产品面向光量子计算规模化、芯片化与工程化目标,基于高速可编程薄膜铌酸锂光量子芯片,集成量子光源、可编程光量子处理芯片、单光子探测以及量子-经典异构计算核心模块,搭建完整的全芯片化、模块化、可扩展整机架构与全栈软硬件体系。
系统创新采用空时复用架构,将空间光路、时间循环与高速电光调控整合进统一可编程网络,让同一组物理器件可以在不同时间模式下重复参与量子演化,结合空间模式共同构建大规模时空计算网络。其中高斯玻色采样核心计算单元“致远3号”,支持单芯片万光子级、百万模式数计算资源扩展,在系统规模与实际损耗的严格边界条件下达成芯片级量子优越性,同步开启世界模型动力学预测等AI前沿方向的探索。
为突破损耗瓶颈,团队同步推进时空模式扩容与全链路低损耗优化,对量子光源、片上传输、器件调控、芯片耦合、单光子探测全链条持续打磨。经过多轮迭代,薄膜铌酸锂光量子芯片光子线路传输损耗低至0.03dB/cm,关键单器件插入损耗低于0.1dB,光纤至芯片单端耦合损耗达到0.9dB/facet,晶圆级量子光源光谱纯度超过99%,系统总损耗成功跨过量子优越性演示的关键门槛。
优异硬件指标背后,是图灵量子建立的“设计—制造—测试—反馈—再迭代”晶圆级芯片工艺闭环。团队将优化目标从单一器件性能,拓展到晶圆级一致性、参数分布与批次重复性,持续迭代传输、调控、耦合等关键环节能力,为大规模光量子芯片和整机系统持续扩展筑牢工艺底座。在系统验证实验中,团队针对不同光子规模下高斯玻色采样输出结果开展统计核验,采集约8000组不同输出事件逐项比对,实测数据与理论预测高度吻合,验证大规模高斯玻色采样计算逻辑的正确性。
TuringQ Gen3不只是一台量子硬件原型,同时具备良好易用性、鲁棒性与经济性,打造完整量子-经典异构软硬件栈。硬件层面自研XLink低延迟互联架构,将量子处理单元QPU、专用量子加速单元与CPU、GPU等经典算力接入统一异构计算体系。软件层面打造DeepQuantum量子编程框架、量擎量子计算云平台、QAgent等全套量子经典混合工具链,覆盖量子算法开发、算力调用、任务调度全流程,把复杂底层量子硬件封装为可直接调用的算力服务,大幅降低量子算法开发门槛。
在产业落地层面,图灵量子加快量子智算中心布局,将光量子计算机接入现有智算基础设施,实现量子算力与经典算力统一调度、稳定部署。团队围绕人工智能、生物医药、金融科技等领域开展联合验证,挖掘高斯玻色采样在世界模型动力学预测等前沿任务的价值。
图灵量子创始人金贤敏表示,具备实际价值的量子优势,无法由单一企业定义。如同GPU从专业计算工具走向各行各业,量子计算发展同样需要广大科研人员、开发者、行业用户深度参与,依托真实业务场景检验量子算力价值。只有推动量子计算走进产业场景,在实践中验证优势、挖掘价值,才能持续拓展应用边界,促进量子计算与实体经济深度融合。
TuringQ Gen3的发布,集中体现图灵量子在光量子芯片工程、软硬件生态构建、产业应用转化方面的综合能力。该成果推动光量子计算由单纯量子优越性验证,迈向大规模可编程计算和产业价值挖掘,加速光量子计算工程化落地进程。随着量子智算中心持续建设与应用场景不断拓展,光量子算力有望成为新一代算力基础设施的重要组成部分,为人工智能、生物医药、金融等领域带来全新计算范式。
本文转自媒体报道或网络平台,系作者个人立场或观点。我方转载仅为分享,不代表我方赞成或认同。若来源标注错误或侵犯了您的合法权益,请及时联系客服,我们作为中立的平台服务者将及时更正、删除或依法处理。






联系电话:
010-61853490
新闻投稿:
server@icviews.cn
商务合作:
business@icviews.cn
问题反馈:
19800315212(微信同号)


半导纵横公众号

半导纵横小程序